[1편] K-EXAONE 236B 하이브리드 어텐션 분석 – 256K 컨텍스트 KV 캐시가 12GB로 끝나는 이유
작성자: 관리자A · 게시판: 자유게시판 · 2026-11-10 11:28 · 추천 1 · 댓글 1
요약
K-EXAONE-236B-A23B는 48개 층 중 12개만 글로벌 어텐션을 쓰고, 나머지 36개 층은 윈도우 128짜리 슬라이딩 윈도우 어텐션(SWA)을 씁니다.
공개된 구조로 계산하면 BF16 기준 256K 컨텍스트의 KV 캐시는 요청 1건당 약 12.0GiB입니다. 전부 글로벌로 구성했을 때(48GiB)의 정확히 4분의 1입니다.
LG AI연구원이 밝힌 "H200 4장으로 256K 서빙 가능"이라는 설명도 이 계산과 맞아떨어집니다.
최근 엑사원 검색량이 다시 늘어서, 이번 글에서는 K-EXAONE의 어텐션 구조와 KV 캐시 크기를 계산해 소개하려고 합니다. 벤치마크 점수는 이미 많이 다뤄졌으니, 이 글은 서빙 관점에 집중하겠습니다.
1. 공개된 구조
Hugging Face 모델 카드에 공개된 값입니다.
항목 | 값 |
|---|---|
전체 / 활성 파라미터 | 236B / 23B (MoE, 전문가 128개 중 8개 + 공유 전문가 1개) |
층 수 | 48 (+ MTP 1층) |
어텐션 패턴 | 12 × (SWA 3층 + 글로벌 1층) |
Q 헤드 / KV 헤드 | 64 / 8 (GQA) |
head dim | 128 |
SWA 윈도우 | 128 토큰 |
글로벌 층 위치 인코딩 | NoPE (RoPE 미사용) |
최대 컨텍스트 | 262,144 토큰 (256K) |
이 중 KV 캐시 크기를 결정하는 핵심은 KV 헤드 8개(GQA)와 3:1 하이브리드 구조, 이 두 가지입니다.
2. 계산 과정
토큰 1개, 층 1개당 KV 캐시 크기는 다음과 같습니다.
2(K, V) × 8(KV 헤드) × 128(head dim) × 2byte(BF16) = 4,096byte = 4KiB글로벌 층 12개는 컨텍스트 전체를 저장해야 합니다.
12 × 4KiB × 262,144 = 12GiBSWA 층 36개는 최근 128토큰만 저장하면 됩니다.
36 × 4KiB × 128 = 18MiB ← 컨텍스트 길이와 무관합계는 약 12.02GiB이고, SWA 층이 차지하는 몫은 18MiB로 컨텍스트 길이와 상관없이 고정이라 사실상 무시할 수 있는 수준입니다.
비교를 위해 가정을 바꿔 보면 다음과 같습니다.
48층 전부 글로벌(GQA 유지): 48GiB
48층 전부 글로벌 + MHA(KV 헤드 64개): 384GiB
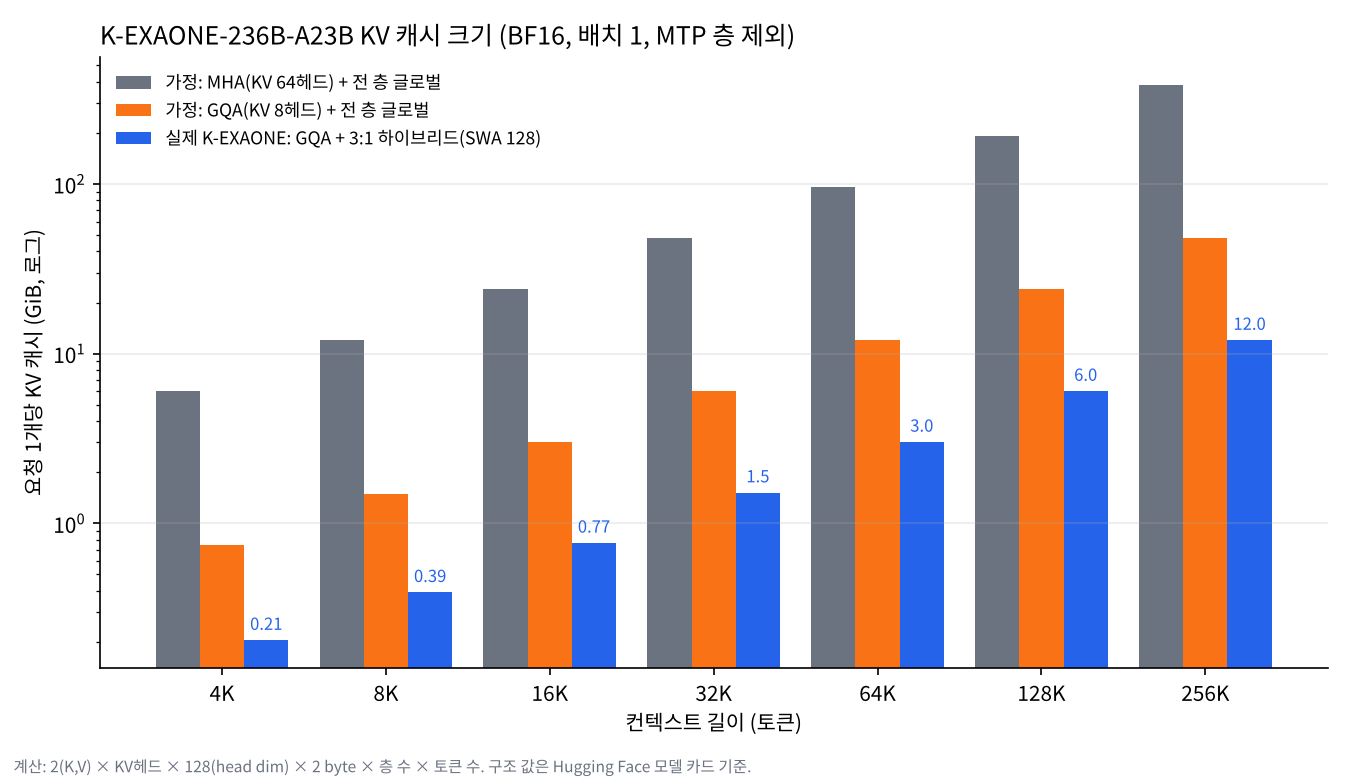
GQA로 8배, 하이브리드 구조로 다시 4배가 줄어 MHA 대비 32배 차이가 납니다.
3. 서빙 스펙과 비교
모델 카드에는 vLLM 기준으로 H200 4장(TP=4)에서 256K 컨텍스트 서빙이 가능하다고 나와 있습니다.
가중치(BF16): 236B × 2byte ≈ 472GB
H200 4장의 HBM 합계: 141GB × 4 = 564GB
남는 공간: 약 90GB (여기서 활성화값, CUDA 그래프 같은 오버헤드를 빼야 합니다)
256K 요청 1건에 KV 캐시 12GiB가 필요하니, 풀 컨텍스트 요청 몇 건은 동시에 처리할 수 있다는 계산이 나옵니다. 전부 글로벌 구조였다면(48GiB) 풀 컨텍스트 요청 1건도 빠듯했을 것입니다.
4. 함께 짚어볼 부분
SWA에도 대가가 있습니다. 윈도우 128은 꽤 공격적인 값이라, 멀리 떨어진 정보는 글로벌 층 12개가 전부 담당합니다. 장문 성능은 기술 보고서의 롱 컨텍스트 벤치마크를 따로 확인하시길 권합니다.
글로벌 층에 RoPE를 쓰지 않는(NoPE) 설계는 길이 일반화를 노린 것으로 보입니다. 로컬 위치 정보는 SWA 층이 맡는 구조입니다.
KV 캐시를 FP8로 양자화하면(vLLM의
--kv-cache-dtype fp8) 위 수치가 다시 절반이 됩니다. 다만 품질 영향은 별도로 검증해야 합니다.라이선스는 "K-EXAONE AI Model License Agreement"라는 별도 라이선스입니다. 상업적으로 사용하실 계획이라면 저장소의 LICENSE 파일을 직접 확인하셔야 합니다.
5. 다른 모델에 적용하는 방법
config.json에서 num_hidden_layers, num_key_value_heads, head_dim, sliding_window와 레이어별 어텐션 타입만 확인하면 같은 방식으로 계산할 수 있습니다. 서빙 견적을 낼 때 "가중치 + KV 캐시 × 동시 요청 수"를 먼저 계산해 보시면 OOM이 나기 전에 대부분의 문제를 걸러낼 수 있습니다.
References
LG AI Research, K-EXAONE-236B-A23B 모델 카드, Hugging Face. https://huggingface.co/LGAI-EXAONE/K-EXAONE-236B-A23B
LG AI Research, K-EXAONE Technical Report, arXiv:2601.01739 (2026). https://arxiv.org/abs/2601.01739
Ainslie et al., GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, arXiv:2305.13245 (2023). https://arxiv.org/abs/2305.13245
Jiang et al., Mistral 7B, arXiv:2310.06825 (2023). https://arxiv.org/abs/2310.06825
Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention, arXiv:2309.06180 (2023). https://arxiv.org/abs/2309.06180