[11편] 2026 로컬 LLM 총정리: 내 PC 메모리별 추천 모델, Ollama·LM Studio·vLLM 선택법, 보안까지
작성자: 관리자A · 게시판: 자유게시판 · 2026-11-19 11:00 · 추천 0 · 댓글 0
먼저 결론
24GB GPU(또는 32GB Mac) 한 대라면 지금 범용 1순위는 Qwen3.8-27B입니다. Apache 2.0, 262K 컨텍스트, 4-bit 기준 17~19GB.
16GB 노트북·GPU라면 gpt-oss-20b 또는 Gemma 4 12B가 가장 무난합니다.
로컬 코딩 에이전트는 10월에 나온 Flint(40B 중 2.5B만 활성)를 눈여겨볼 만합니다. 다만 벤치마크는 아직 제작사 발표 수치입니다.
도구는 혼자 쓰면 Ollama, 화면으로 고르고 싶으면 LM Studio, 여러 명이 동시에 쓰면 vLLM으로 정리됩니다.
Ollama를 0.0.0.0으로 열어 외부에 노출하지 마세요. 올해 인증 없이 메모리를 읽어가는 치명적 취약점(CVE-2026-7482)이 나왔고, 노출 서버가 30만 대 규모로 추정됐습니다.
안녕하세요. 이번 11편에서는 개발자분들이 요즘 가장 많이 물어보시는 주제, "내 컴퓨터에서 LLM 돌리려면 뭘 깔고 어떤 모델을 받아야 하나"를 2026년 11월 기준으로 한 번에 정리해 드리겠습니다.
올해 하반기는 로컬 LLM 쪽에 유난히 굵직한 일이 많았습니다. 6월 Gemma 4 12B, 8월 Meta의 Muse Glimmer와 Qwen3.8-27B, 10월 Flint까지 쓸 만한 모델이 전부 Apache 2.0으로 풀렸습니다. 하드웨어 쪽에서도 NVIDIA가 최대 128GB 통합 메모리를 쓰는 RTX Spark 노트북을 10월부터 출시했습니다. 선택지가 늘어난 만큼 헷갈리기도 쉬워서, 기준부터 차근차근 잡아 보겠습니다.
1. 비유로 먼저: 클라우드는 택시, 로컬은 자가용
ChatGPT·Claude 같은 API는 택시입니다. 부르면 오고, 탄 만큼(토큰만큼) 냅니다. 로컬 LLM은 자가용입니다. 처음에 차값(GPU·메모리)이 들지만 이후엔 기름값(전기료)만 들고, 무엇을 싣고 어디로 가는지 아무도 모릅니다.
여기서 중요한 점은 어떤 차를 살지보다 주차장(메모리)이 얼마나 넓은지가 먼저라는 것입니다. 모델이 메모리에 다 들어가지 않으면 시스템 RAM으로 넘쳐서 속도가 몇 분의 1로 떨어집니다. 그래서 로컬 LLM 선택은 항상 "내 VRAM/통합 메모리가 몇 GB냐"에서 시작합니다.
2. 꼭 알아야 할 용어 4가지
용어 | 뜻 | 실무에서 의미 |
|---|---|---|
파라미터(B) | 모델 크기. 27B = 270억 개 숫자 | 메모리 사용량을 결정 |
양자화(Q4, Q8…) | 숫자를 16비트에서 4~8비트로 줄여 저장 | Q4면 원본의 약 1/4 크기. 품질 손실은 생각보다 작음 |
컨텍스트 / KV 캐시 | 한 번에 기억하는 대화 길이 | 길게 쓸수록 메모리를 추가로 먹음 (1편 KV 캐시 글 참고) |
MoE (총/활성) | 전문가 여러 명 중 일부만 그때그때 일함 | 총 파라미터 = 메모리, 활성 파라미터 = 속도 |
어림 계산법 하나만 기억하시면 됩니다. 4-bit 기준 필요한 메모리 ≈ 파라미터(B) × 0.6GB + 컨텍스트 여유 2~6GB. 예를 들어 27B 모델은 약 16GB에 여유분을 더해 24GB 카드가 딱 맞습니다. 실제로 Unsloth는 Qwen3.8-27B 4-bit 권장 GGUF에 17~19GB를 잡으라고 안내합니다.
MoE는 특히 로컬에서 재미있는 구조입니다. Flint는 총 40B지만 토큰마다 2.5B만 계산하기 때문에, 메모리는 40B급으로 먹고 속도는 3B급으로 나옵니다. 반대로 메모리가 부족하면 MoE도 소용이 없습니다.
3. 메모리별 추천 모델 지도
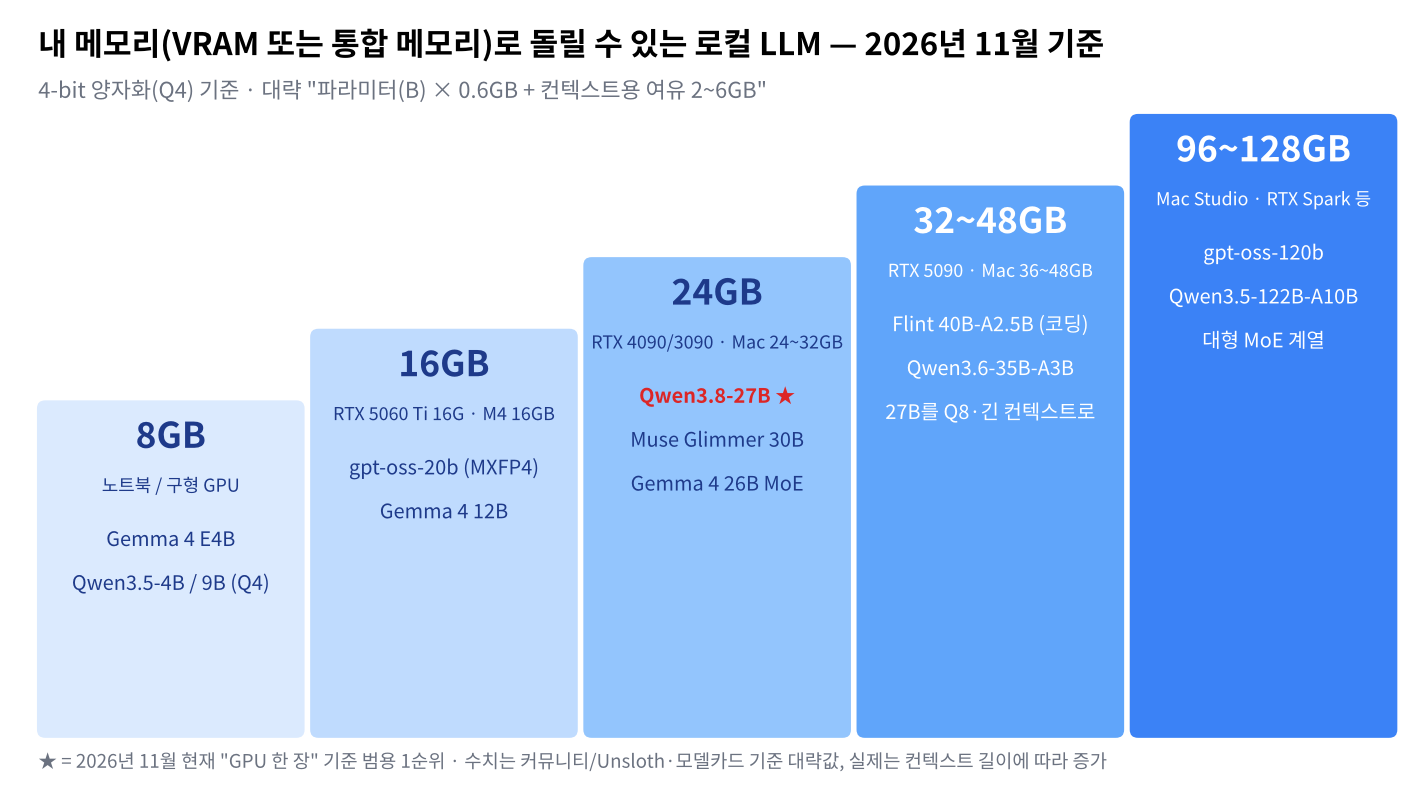
내 메모리 | 대표 장비 | 추천 모델 | 메모 |
|---|---|---|---|
8GB | 노트북 내장, 구형 GPU | Gemma 4 E4B, Qwen3.5-4B/9B | 요약·분류·간단한 질의응답용 |
16GB | RTX 5060 Ti 16G, M 시리즈 16GB | gpt-oss-20b, Gemma 4 12B | gpt-oss-20b는 MXFP4로 16GB 안에 들어가도록 설계 |
24GB | RTX 4090/3090, Mac 24~32GB | Qwen3.8-27B, Muse Glimmer 30B, Gemma 4 26B MoE | 현재 가성비가 가장 좋은 구간 |
32~48GB | RTX 5090, Mac 36~48GB | Flint(코딩), Qwen3.6-35B-A3B, 27B를 Q8로 | 긴 컨텍스트 에이전트 작업에 여유 |
96~128GB | Mac Studio, RTX Spark, AI Max+ 미니PC | gpt-oss-120b, Qwen3.5-122B-A10B | 대형 MoE를 한 대에서 |
주의: 표의 메모리는 "모델이 겨우 올라가는" 기준입니다. 코딩 에이전트처럼 컨텍스트를 수만 토큰 이상 쓰면 KV 캐시가 수 GB씩 더 붙습니다. 24GB 카드에 19GB 모델을 올리면 긴 컨텍스트는 사실상 어렵다고 보셔야 합니다.
4. 지금 주목할 모델 한눈에 보기
모델 | 공개 | 구조 | 라이선스 | 컨텍스트 | 한 줄 평 |
|---|---|---|---|---|---|
Qwen3.8-27B | 2026.08.14 | 27B dense, 텍스트·이미지·영상 입력 | Apache 2.0 | 262K | 단일 GPU 범용 1순위 |
Gemma 4 12B | 2026.06.03 | 12B dense, 인코더 없는 멀티모달(오디오 포함) | Apache 2.0 | 256K | 16GB 노트북 겨냥 |
gpt-oss-20b | 2025.08 | 21B MoE(활성 3.6B), MXFP4 | Apache 2.0 | 128K | 검증된 16GB 선택지 |
Muse Glimmer | 2026.08.10 | 30B dense, 에이전트 특화 | Apache 2.0 | 128K | Meta가 Llama 4 이후 처음 낸 오픈 웨이트 |
Flint | 2026.10.21 | 40B MoE(활성 약 2.5B) | Apache 2.0 | 262K | 로컬 코딩 에이전트 전용 |
Qwen3.6-35B-A3B | 2026.04.16 | 35B MoE(활성 3B) | Apache 2.0 | 262K | 빠른 MoE, 32GB 이상에서 |
주목할 흐름이 두 가지 있습니다. 첫째, 주요 로컬 모델이 거의 다 Apache 2.0으로 정리됐습니다. Meta도 Llama 커뮤니티 라이선스 대신 Muse Glimmer를 Apache 2.0으로 냈기 때문에, 사내 도입 시 법무 검토가 훨씬 단순해졌습니다. 둘째, 27~30B dense 모델이 "GPU 한 장" 표준 크기로 자리 잡았습니다.
벤치마크는 걸러서 보세요. Flint의 SWE-bench Pro v2 89.7%, Qwen3.8-27B의 에이전트 점수는 모두 제작사 자체 발표입니다. 출시 당시 독립 재현 결과가 없었다는 지적도 있었습니다. 내 코드베이스에서 직접 10~20개 작업을 돌려 보는 게 가장 정확합니다.
5. 실행 도구: Ollama vs LM Studio vs llama.cpp vs vLLM
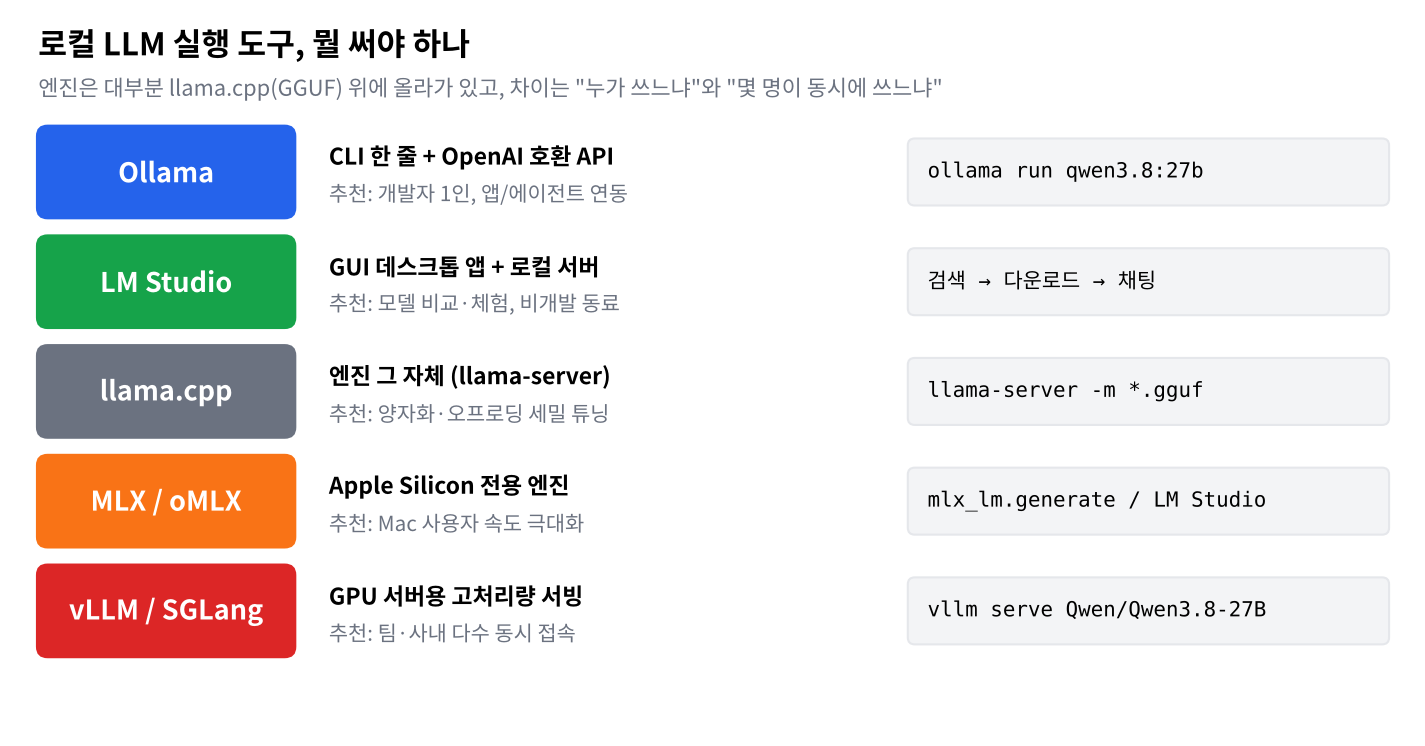
도구가 많아 보이지만 구조는 단순합니다. 대부분 llama.cpp(GGUF 포맷) 엔진 위에 편의 기능을 얹은 형태이고, 서버용으로는 vLLM·SGLang이 따로 있습니다.
도구 | 최신 버전(11월 기준) | 장점 | 이런 분께 |
|---|---|---|---|
Ollama | 0.40.16 (11/9 안정판) | 명령어 한 줄, OpenAI 호환 API, 모델 라이브러리 | 앱·에이전트에 붙이려는 개발자 |
LM Studio | 0.4.28 (10/31) | GUI로 검색·비교, 0.4부터 병렬 요청·헤드리스 서버 | 모델 이것저것 써 보고 싶은 분, 비개발 동료 |
llama.cpp | 상시 업데이트 | 양자화·GPU/CPU 분할을 가장 세밀하게 조정 | 성능을 끝까지 짜내고 싶은 분 |
MLX | 상시 업데이트 | Apple Silicon 최적화 | Mac 사용자 (LM Studio에서도 선택 가능) |
vLLM | v0.33.0 (11/2, CUDA 13 전용 빌드) | 연속 배칭, 높은 동시 처리량 | 팀·사내 서버로 여러 명이 동시에 쓸 때 |
혼자 쓰는 개발 PC에 vLLM을 올릴 이유는 거의 없습니다. 반대로 10명 이상이 동시에 붙는 사내 서버를 Ollama 하나로 버티려 하면 대기열이 길어집니다. "몇 명이 동시에 쓰느냐"로 고르시면 대부분 맞습니다.
5분 시작 가이드 (Ollama)
# 1) 모델 받기 (약 18GB)
ollama pull qwen3.8:27b

# 2) 터미널에서 바로 대화
ollama run qwen3.8:27b

# 3) OpenAI 호환 API로 호출
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"qwen3.8:27b","messages":[{"role":"user","content":"안녕"}]}'
기존 OpenAI SDK 코드라면 base_url만 http://localhost:11434/v1로 바꾸면 대부분 그대로 돌아갑니다. 이게 로컬 LLM을 기존 서비스에 붙일 때 가장 편한 지점입니다.
from openai import OpenAI
client = OpenAI(base_url="http://localhost:11434/v1", api_key="ollama")
res = client.chat.completions.create(
    model="qwen3.8:27b",
    messages=[{"role": "user", "content": "이 함수 리팩터링해줘"}],
)
print(res.choices[0].message.content)
6. 로컬 코딩 에이전트로 쓰기
요즘 가장 수요가 많은 활용법입니다. Claude Code·Codex 같은 에이전트 도구를 로컬 모델에 연결하면 코드가 회사 밖으로 한 줄도 나가지 않는 코딩 에이전트를 만들 수 있습니다. Unsloth는 아예 한 줄로 연결하는 명령을 제공합니다.
unsloth start claude --model unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_XL실전에서 체감되는 팁 세 가지입니다.
컨텍스트를 명시적으로 늘리세요. 에이전트는 파일 여러 개를 한꺼번에 읽어서 기본 컨텍스트로는 금방 잘립니다. Ollama는 VRAM 24GiB 미만이면 기본 4K, 24~48GiB면 32K 컨텍스트로 시작하는데, 공식 문서도 에이전트·코딩 도구에는 최소 64K를 권합니다.
OLLAMA_CONTEXT_LENGTH=64000 ollama serve처럼 서버를 띄우는 쪽에 설정해야 적용됩니다(클라이언트 셸에만 넣으면 안 먹습니다). 메모리 여유를 꼭 같이 확인하세요.코딩 전용이면 MoE가 체감상 빠릅니다. Flint처럼 활성 파라미터가 작은 모델은 같은 장비에서 토큰 생성 속도가 dense 27B보다 훨씬 빠릅니다.
어려운 작업은 클라우드로 넘기는 하이브리드가 현실적입니다. 로컬 모델이 많이 따라왔지만 최상위 상용 모델과의 격차는 아직 남아 있습니다. 반복적이고 민감한 작업은 로컬, 큰 설계 판단은 API로 나누는 팀이 많습니다.
7. 보안: 로컬이라고 안전한 게 아닙니다
로컬 LLM 사고의 대부분은 모델이 아니라 "서버를 밖으로 열어 둔 설정"에서 나옵니다.
올해 5월 공개된 CVE-2026-7482("Bleeding Llama")는 CVSS 9.1의 Ollama 취약점으로, 인증 없이 프로세스 메모리(시스템 프롬프트, API 키, 다른 사용자 대화 등)를 읽어갈 수 있었습니다. 0.17.1에서 패치됐고, 공개 당시 인터넷 노출 인스턴스가 약 30만 대로 추정됐습니다.
Windows용 Ollama는 0.12.10~0.17.5 버전에서 업데이트 파일 서명을 검증하지 않는 취약점(CVE-2026-42248/42249)도 공개됐습니다. 자동 업데이트가 조용히 실행되는 구조라 오래된 버전을 쓰고 있다면 꼭 최신으로 올리세요.
Ollama의 기본 바인드는 127.0.0.1이지만, 원격 접속하려고
OLLAMA_HOST=0.0.0.0으로 바꾸는 경우가 아주 흔합니다.Cloud Security Alliance 정리에 따르면, 조사 대상 Ollama 서버 5,200여 대 중 31%가 인증 없는 테스트 프롬프트에 그대로 응답했습니다. Open WebUI·Flowise 같은 주변 도구도 함께 노출된 사례가 많았습니다.
체크리스트
항목 | 해야 할 일 |
|---|---|
버전 | Ollama·LM Studio·llama.cpp 최신 유지 (Ollama는 최소 0.17.1, Windows는 0.17.5 초과) |
바인드 | 외부 공개가 필요 없으면 127.0.0.1 유지 |
원격 접속 | 0.0.0.0 대신 Tailscale·VPN이나, 인증 붙인 리버스 프록시(nginx 등) 뒤에 두기 |
방화벽 | 11434(Ollama), 1234(LM Studio), 8000(vLLM) 포트 외부 차단 확인 |
UI 도구 | Open WebUI 등은 관리자 계정·회원가입 제한부터 설정 |
모델 파일 | 출처 불분명한 GGUF는 받지 않기 (공식·Unsloth·bartowski 등 검증된 저장소 위주) |
8. 그래서 뭘 해야 하나: 상황별 추천
상황 | 추천 조합 | 이유 |
|---|---|---|
맥북 16GB, 처음 써 봄 | LM Studio + Gemma 4 12B | 설치 5분, GUI로 바로 비교 |
RTX 4090/5080 데스크톱 개발자 | Ollama + Qwen3.8-27B | API로 앱에 붙이기 쉽고 품질이 가장 안정적 |
로컬 코딩 에이전트 | Ollama 또는 llama.cpp + Flint / Qwen3.8-27B | 코드 외부 유출 없음, MoE는 빠름 |
사내 10명 이상 공용 서버 | vLLM + Qwen3.8-27B(FP8) | 동시 요청 처리량이 압도적 |
128GB 통합 메모리 장비 | LM Studio/llama.cpp + gpt-oss-120b | 대형 MoE를 한 대에서 |
처음 시작하신다면 이 순서를 권해 드립니다.
내 VRAM/통합 메모리 용량을 확인합니다.
위 표에서 내 구간의 모델 1개를 고릅니다.
Ollama나 LM Studio로 받아서 평소 쓰던 프롬프트 10개를 돌려 봅니다.
쓸 만하면 OpenAI 호환 API로 내 도구에 연결합니다.
외부에서 접속하려면 반드시 인증과 방화벽부터 설정합니다.
9. 자주 묻는 질문
Q. 양자화하면 많이 멍청해지나요?
Q4_K_M이나 Unsloth의 UD-Q4_K_XL 정도면 체감 손실이 작아서 대부분 이 구간을 씁니다. 3비트 이하로 내려가면 코딩·수학에서 차이가 눈에 띄기 시작합니다.
Q. 한국어는 잘 하나요?
Qwen·Gemma 계열은 다국어 학습 비중이 커서 일상 대화와 요약은 무난합니다. 다만 전문 용어나 존댓말 톤은 모델마다 차이가 크니 내 업무 문장으로 직접 테스트해 보시는 걸 권합니다.
Q. GPU 없이 CPU만으로는요?
4B~9B급은 돌아가지만 27B급은 답답할 정도로 느립니다. 이 경우 MoE 모델(활성 파라미터가 작은 모델)이 그나마 현실적입니다.
다음 편에서는 같은 질문 20개를 실제로 돌려서 모델별 속도와 품질을 비교해 보겠습니다. 쓰고 계신 장비와 모델 조합을 댓글로 남겨 주시면 테스트에 반영하겠습니다.
References
QwenLM, Qwen3.8 GitHub (릴리스 내역). https://github.com/QwenLM/Qwen3.8
Unsloth, Qwen3.8 - How to Run Locally. https://unsloth.ai/docs/models/qwen3.8-27b
Google, Introducing Gemma 4 12B. https://blog.google/innovation-and-ai/technology/developers-tools/introducing-gemma-4-12b/
OpenAI, gpt-oss-20b 모델 카드 (Hugging Face). https://huggingface.co/openai/gpt-oss-20b
InfoQ, Meta Muse Glimmer. https://infoq.com/news/2026/08/meta-muse-glimmer
VKTR, Recursive Launches Flint. https://www.vktr.com/ai-platforms/recursive-launches-flint-to-keep-ai-coding-offline-and-on-device/
Ollama 공식 문서, Context length. https://docs.ollama.com/context-length
CERT Polska, CVE-2026-42248/42249. https://cert.pl/en/posts/2026/04/CVE-2026-42248/
Ollama Releases. https://github.com/ollama/ollama/releases
LM Studio Changelog. https://lmstudio.ai/changelog
LM Studio, Introducing LM Studio 0.4.0. https://lmstudio.ai/blog/0.4.0
vLLM Releases. https://github.com/vllm-project/vllm/releases
Bleeding Llama: CVE-2026-7482 정리. https://rits.shanghai.nyu.edu/ai/bleeding-llama-critical-unauthenticated-memory-leak-hits-300000-ollama-servers/
Cloud Security Alliance, Exposed AI Infrastructure. https://labs.cloudsecurityalliance.org/research/csa-research-note-exposed-ai-infrastructure-selfhosted-secur/
Jon Peddie Research, NVIDIA RTX Spark. https://www.jonpeddie.com/news/nvidia-rtx-spark-a-new-beginning-for-windows-pcs/