[6편] 아웃룩·팀즈 15시간 넘게 먹통, '헬스체크 연쇄 실패'로 번졌다 – MS 365 글로벌 장애로 보는 개발자 체크리스트
작성자: 관리자A · 게시판: 자유게시판 · 2026-11-13 17:51 · 추천 0 · 댓글 1
먼저 결론 (11월 13일 오후 기준)
11월 12일(미국 시간)부터 아웃룩·Exchange Online을 중심으로 팀즈, 코파일럿 등 MS 365 서비스가 전 세계적으로 15시간 넘게 장애를 겪고 있습니다. 한국에서는 13일 새벽부터 영향이 있었습니다.
MS는 해킹이 아니라고 밝혔고, 트래픽이 늘어서가 아니라 서버 상당수가 헬스체크에 실패해 빠지면서 남은 서버에 부하가 몰린 것이라고 설명했습니다. 최종 근본 원인은 아직 발표되지 않았습니다.
우리 서비스에도 그대로 적용되는 교훈이 있습니다. 헬스체크가 장애를 키울 수 있고, 복구할 때 다시 쓰러질 수 있다는 점입니다. 6장에 체크리스트로 정리했습니다.
이번 주 한국 구글 트렌드 기술 분야 1위가 "아웃룩", "MS 장애"였습니다. 출근했더니 메일이 안 열려서 당황하신 분들 많으셨을 겁니다. 이번 글에서는 무슨 일이 있었는지 정리하고, 이 장애에서 우리가 만드는 서비스에 가져갈 교훈을 소개해 드리겠습니다.
1. 무슨 일이 있었나
시각 (한국시간) | 내용 |
|---|---|
11/13 새벽 3시경 | MS, 미주 지역 Exchange Online 메일함 접속 문제 조사 착수 공지 |
오전 4시경 | "부하 증가는 트래픽 증가 때문이 아니다"라고 판단 (영국 시각 19:18) |
오전 8시경 | 일부 서버를 복귀시켰지만 "트래픽을 받으면 다시 응답 불능이 될 수 있다"고 공지 |
오전 10시경 | 영향받은 서버에서 보안 연결을 처리하는 핵심 프로세스가 과부하됐다고 발표 |
오후 4시 25분 | 15시간 넘게 진행 중, 복구 예정 시각과 근본 원인 모두 미발표 (UC Today 기준) |
(시각은 MS 공지와 보도를 바탕으로 환산한 대략적인 시점입니다. 상황이 계속 바뀌고 있으니 올리기 직전 최신 상태를 한 번 확인해 주세요.)
영향 범위: Outlook, Exchange Online을 중심으로 Teams, SharePoint, OneDrive, Microsoft 365 Copilot, Defender XDR, 관리 센터 등. MS 공지 기준 Exchange Online 외에 18개 서비스가 영향 목록에 올랐고, Outlook.com 같은 개인용 서비스도 포함됐습니다. 메일과 연동되지 않는 기능은 정상 동작했습니다.
규모: 다운디텍터에 아웃룩 관련 신고만 13만 건 가까이 접수됐다는 보도가 있습니다. 호주 정보기관과 연방경찰도 영향을 받았다고 알려졌습니다.
AI 서비스도 멈췄습니다: OpenAI와 Anthropic도 각자의 Microsoft 365 커넥터에 문제가 생겼다고 알렸습니다. AI 에이전트가 메일·문서에 접근하는 경로가 같은 인프라에 묶여 있기 때문입니다.
별개 장애도 겹쳤습니다: 같은 날 Dynamics 365 콘택트센터가 8시간 가까이 멈췄는데, MS는 이를 다른 원인의 별도 사건(CR1550885)으로 분류했습니다.
사건 번호: EX1550543 (Exchange Online), MO1550821 (Microsoft 365 전체). 관리자 센터에서 진행 상황을 볼 수 있고, MS는 복구 후 사후 보고서(PIR)를 공개하겠다고 밝혔습니다.
2. 비유로 이해하기: 계산대가 하나씩 쓰러지는 마트
대형 마트에 계산대가 100개 있다고 해보겠습니다. 관리자는 1분마다 각 계산대를 점검해서 응답이 느린 계산대는 자동으로 닫습니다. 평소에는 좋은 장치입니다. 그런데 어떤 이유로 계산대 30개가 동시에 느려지면 어떻게 될까요?
30개가 닫히면 손님이 나머지 70개로 몰립니다. 그러면 멀쩡하던 계산대도 줄이 길어져 느려지고, 점검에 걸려 또 닫힙니다. 이게 반복되면 결국 마트 전체가 멈춥니다. 닫았던 계산대를 다시 열어도 기다리던 손님이 한꺼번에 몰려 바로 또 쓰러집니다. 이번 MS 장애에서 "복구한 서버가 트래픽을 받으면 다시 다운된다"는 공지가 나온 이유입니다.
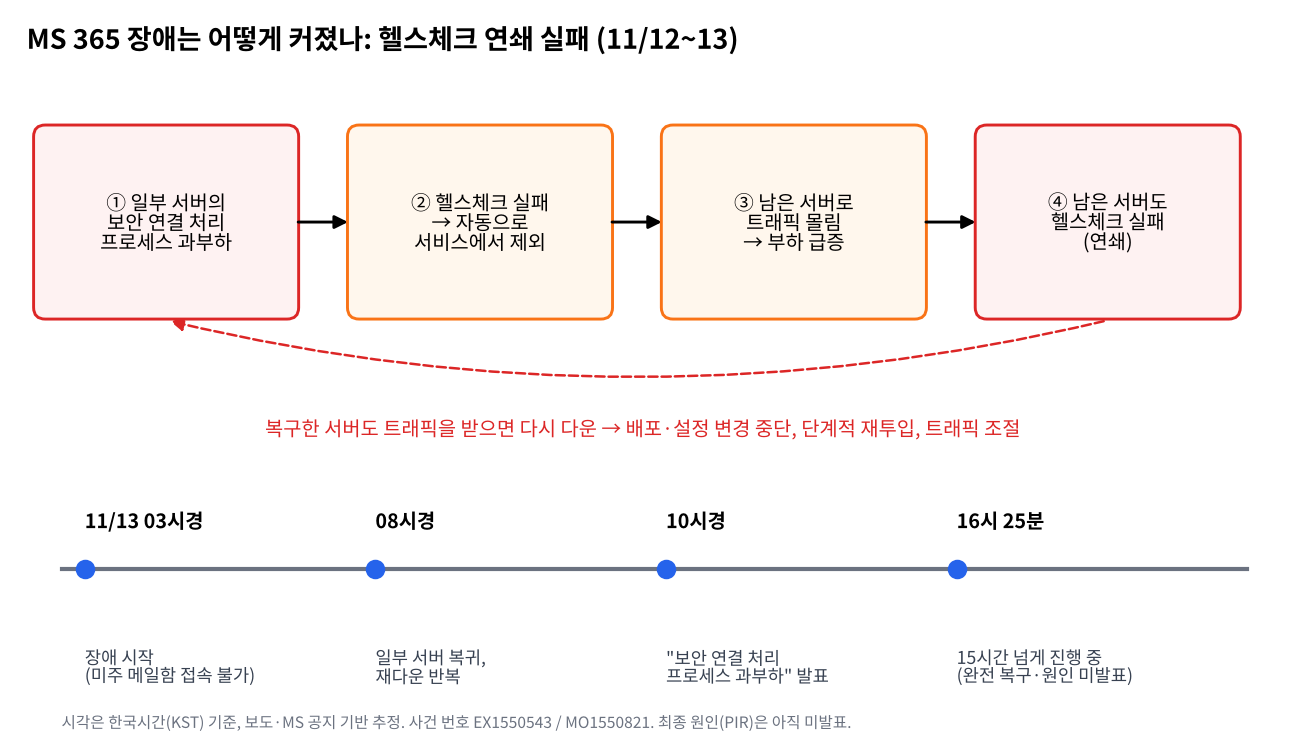
3. 기술적으로 보면: 헬스체크 연쇄 실패
MS가 공개한 내용을 이어 보면 다음과 같은 흐름입니다.
일부 서버에서 보안 연결(TLS 등)을 맺는 핵심 프로세스가 과부하됩니다.
이 서버들이 자동 헬스체크에 실패해 서비스에서 빠집니다.
남은 서버가 그 트래픽을 떠안으면서 부하가 급증합니다.
남은 서버도 헬스체크에 실패합니다. (연쇄)
원인 설명은 시간이 지나며 여러 번 바뀌었습니다. 처음에는 "부하 증가"라고 했다가, "최근 변경 중 장애 시작과 연관된 것은 없다", "헬스체크 실패가 서버 상태를 처리하는 특정 구성 요소에서 비롯됐을 수 있다"는 업데이트가 이어졌습니다. 이후에는 장애 시작과 시점이 겹치는 네트워크 설정 변경을 되돌리고 있다는 보도도 나왔습니다. 어느 것도 최종 원인으로 확정된 것은 아닙니다.
MS는 복구 과정에서 새 소프트웨어 배포와 설정 변경을 모두 멈췄다고 밝혔습니다. 원인을 모르는 장애 중에는 새로운 변경을 막아 상황을 더 꼬이지 않게 하는 것이 기본입니다. 참고로 장애 이틀 전 MS의 11월 정기 보안 업데이트(패치 화요일)가 있었지만, MS는 이 업데이트와 이번 장애를 연결하지 않았습니다.
4. 반복되는 클라우드 장애
서버 용량이 한꺼번에 사라지면서 MS 365 여러 서비스가 동시에 멈춘 건 올해만 두 번째입니다. 1월 22일에도 북미 인프라 문제로 10시간 가까이 장애가 있었습니다. 특정 회사만의 문제라기보다, 수많은 서비스가 하나의 인증·연결 계층을 공유하는 대형 클라우드 구조에서 반복되는 패턴입니다. 이번에도 아웃룩, 팀즈 연동, 코파일럿, 외부 AI 커넥터처럼 같은 계층을 거치는 서비스가 한꺼번에 영향을 받았습니다.
5. 지금 당장 할 수 있는 것
관리자: 관리자 센터에서 EX1550543, MO1550821을 구독하세요. 관리 센터 자체가 불안정할 수 있으니 MS 365 Status 공식 X 계정도 함께 확인하세요.
사용자: 팀즈 통화·채팅은 상당 부분 동작했다고 MS가 밝혔습니다. 급한 연락은 메일 대신 다른 채널을 쓰세요.
장애를 틈탄 피싱 메일과 가짜 지원 전화가 늘어나니 사내에 공지해 두세요.
6. 그래서 우리 서비스에는 뭘 적용하나
헬스체크를 설계할 때
"한 번에 너무 많이 빼지 않기": 헬스체크 실패 서버가 일정 비율을 넘으면, 오히려 전체 서버에 트래픽을 다시 고르게 나누도록 하세요. Envoy 같은 프록시에는 이를 위한 "패닉 임계값(panic threshold)" 기능이 있습니다.
liveness와 readiness 분리: "프로세스가 살아 있나"와 "지금 트래픽을 받을 수 있나"를 따로 판단하세요. 외부 의존성(DB, 인증 서버) 상태를 헬스체크에 그대로 넣으면, 의존성 하나가 흔들릴 때 전체 서버가 동시에 빠질 수 있습니다.
헬스체크 로직도 장애 지점: 이번에 MS가 언급했듯이 헬스 상태를 처리하는 구성 요소 자체가 문제의 출발점일 수 있습니다. 헬스체크 결과가 한꺼번에 바뀌면 알림이 오도록 모니터링하세요.
복구할 때
점진적으로 재투입하고, 트래픽을 받는 양을 제한하세요. 한꺼번에 열면 밀려 있던 요청이 몰려 다시 쓰러집니다.
부하 차단(load shedding): 처리할 수 없는 요청은 빨리 거절하는 게 모두가 느려지는 것보다 낫습니다.
클라이언트는 지수 백오프 + 지터로 재시도하세요. 모든 클라이언트가 같은 간격으로 재시도하면 복구 순간에 요청 폭탄이 됩니다.
배포 동결(change freeze): 원인을 모르는 장애 중에는 새 배포와 설정 변경을 멈추는 절차를 미리 정해 두세요.
외부 SaaS나 AI 커넥터에 기대는 서비스라면
메일 발송, 캘린더 연동처럼 MS 365(Graph API 등)에 의존하는 기능은 큐에 쌓았다가 재시도하는 구조로 만드세요. 장애 동안 요청이 사라지지 않게 하는 것이 핵심입니다.
AI 에이전트가 MS 365 커넥터로 메일·문서를 읽는 워크플로라면, 커넥터 실패 시 "조용히 빈 결과를 내는" 대신 실패를 명확히 알리도록 만드세요. 빈 메일함을 "메일 없음"으로 오해한 에이전트가 잘못된 판단을 내릴 수 있습니다.
상태 페이지는 본 서비스와 다른 곳에 두세요. 이번에 MS 365 상태 페이지도 한동안 제대로 열리지 않았다는 보도가 있습니다.
7. 한 줄 정리
서버를 보호하려고 만든 장치(헬스체크, 자동 제외)가 장애를 키울 수 있습니다. 우리 서비스의 헬스체크가 "한꺼번에 다 빠지는" 상황에서 어떻게 동작하는지, 이번 기회에 한 번 점검해 보시길 권합니다. MS의 사후 보고서가 나오면 후속 글로 정리하겠습니다.
References
CNN, Global Microsoft outage leaves millions without access to Outlook email, Teams and other tools (2026.11.13). https://edition.cnn.com/2026/11/12/business/live-news/microsoft-global-outage-intl-hnk
NBC News, Microsoft services hit by major outage across the world (2026.11.13). https://www.nbcnews.com/tech/tech-news/outlook-widespread-outage-hits-microsoft-apps-rcna609047
UC Today, Microsoft 365 Outage: Outlook Down, and the Fix Won't Hold (2026.11.13). https://uctoday.com/microsoft-365-outage-outlook-exchange-teams-copilot
Cyber Security News, Microsoft 365 Massive Outage – Fixes Fail as Restored Servers Keep Going Unresponsive. https://cybersecuritynews.com/microsoft-365-massive-outage-fixes-fail-as-restored-servers-keep-going-unresponsive/
SecurityWeek, Microsoft 365 Outage Disrupts Outlook, Exchange Online and Teams. https://www.securityweek.com/microsoft-365-outage-disrupts-outlook-exchange-online-and-teams/
CX Today, Microsoft Outage Cut Agents Off From the Contact Center (2026.11.13). https://cxtoday.com/microsoft-outage-cut-agents-off-from-the-contact-center
Envoy Proxy 문서, Panic threshold. https://www.envoyproxy.io/docs/envoy/latest/intro/arch_overview/upstream/load_balancing/panic_threshold
AWS Builders' Library, Implementing health checks. https://aws.amazon.com/builders-library/implementing-health-checks/
AWS Builders' Library, Timeouts, retries, and backoff with jitter. https://aws.amazon.com/builders-library/timeouts-retries-and-backoff-with-jitter/