[2편] 2026년 로컬 LLM용 그래픽카드 추천 – "VRAM"과 "대역폭" 두 숫자만 보면 됩니다 (예산별 추천 포함)
작성자: 관리자A · 게시판: 자유게시판 · 2026-11-10 12:00 · 추천 1 · 댓글 1
간단한 견해
처음 시작한다면: RTX 5060 Ti 16GB (8GB 모델 말고 꼭 16GB)
가성비를 따진다면: 중고 RTX 3090 24GB
예산 걱정이 없다면: RTX 5090 32GB (다만 지금 가격으로는 업무용이 아니면 권하지 않습니다)
100B급 MoE 모델이 목적이라면: 그래픽카드 대신 통합 메모리 장비(Mac, Ryzen AI Max 계열)
피해야 할 것: 8GB 카드, LLM용으로 산 RTX 5070 12GB, 지금 가격의 16GB 고급형(5070 Ti·5080)
아래는 왜 이렇게 추천하는지에 대한 설명입니다.
"LLM 돌리려는데 그래픽카드 뭐 사야 하나요?"라는 질문을 주위에서 종종 받고는 합니다. 게임용 추천과 LLM용 추천은 기준이 완전히 다릅니다. 이번 글에서는 누구나 직접 판단할 수 있도록 두 가지 숫자만으로 그래픽카드를 고르는 방법을 소개하고, 2026년 11월 가격 상황을 반영한 추천까지 정리해 보겠습니다.
1. 딱 두 숫자만 기억하세요
LLM용 그래픽카드는 이 두 숫자로 거의 결정됩니다.
VRAM(그래픽카드 메모리 용량): 어떤 크기의 모델을 "올릴 수 있는지"를 정합니다.
메모리 대역폭: 올린 모델이 "얼 정합니다.
책상에 비유하면 쉽습니다. VRAM은 책상 크기입니다. 책상이 작으면 큰 책(큰 모델)을 아예 펼칠 수 없습니다. 대역폭은 책장을 넘기는 속도입니다. LLM은 단어 하나를 쓸 때마다 책 전체를 한 번씩 훑어봐야 하기 때문에, 넘기는 속도가 곧 답변 속도가 됩니다.
게임 성능을 좌우하는 코어 수나 클럭은 LLM 답변 속도에 생각보다 영향이 작습니다. 이 점이 게임용 추천과 가장 크게 다른 부분입니다.
2. 내 카드에는 어떤 모델이 올라갈까? (VRAM)
가장 많이 쓰는 4bit 양자화(Q4_K_M) 기준으로 간단한 공식이 있습니다.
필요한 VRAM ≈ 모델 크기(B) × 0.6GB + 여유분 1.5~2GB예를 들어 8B 모델은 8 × 0.6 = 약 4.8GB에 여유분을 더해 6~7GB면 충분합니다. 32B 모델은 약 19.4GB에 여유분을 더해 22GB 정도가 필요합니다.
VRAM | 올라가는 모델 (Q4 기준) |
|---|---|
8GB | 8B까지. 입문용 맛보기 수준 |
12GB | 14B까지 편하게 |
16GB | 14B는 긴 대화까지 여유, 20B대는 빠듯하게 |
24GB | 32B급. 실사용 만족도가 크게 올라가는 구간 |
32GB | 32B급 + 긴 컨텍스트(긴 문서)까지 여유 |
여유분이 필요한 이유는 대화 내용을 기억하는 공간(KV 캐시) 때문입니다. 대화가 길어지거나 긴 문서를 넣을수록 이 공간이 커집니다.
VRAM이 모자라면 남는 부분을 CPU와 일반 RAM으로 넘겨서 돌릴 수는 있습니다. 하지만 이 경우 속도가 몇 분의 1로 떨어집니다. 로컬 LLM에서 가장 흔한 실패가 "일단 돌아가긴 하는데 너무 느린" 상황입니다.
3. 얼마나 빠를까? (대역폭)
답변 속도의 이론적인 상한은 이렇게 계산할 수 있습니다.
속도 상한(tok/s) ≈ 메모리 대역폭(GB/s) ÷ 모델 크기(GB)LLM은 토큰(대략 한글 한두 글자) 하나를 만들 때마다 모델 전체를 메모리에서 한 번 읽어야 합니다. 이때 그래픽카드의 계산 능력은 대부분 놀고 있고, 메모리에서 데이터를 퍼오는 속도가 병목이 됩니다. 그래서 이 단순한 나눗셈이 꽤 잘 맞습니다.
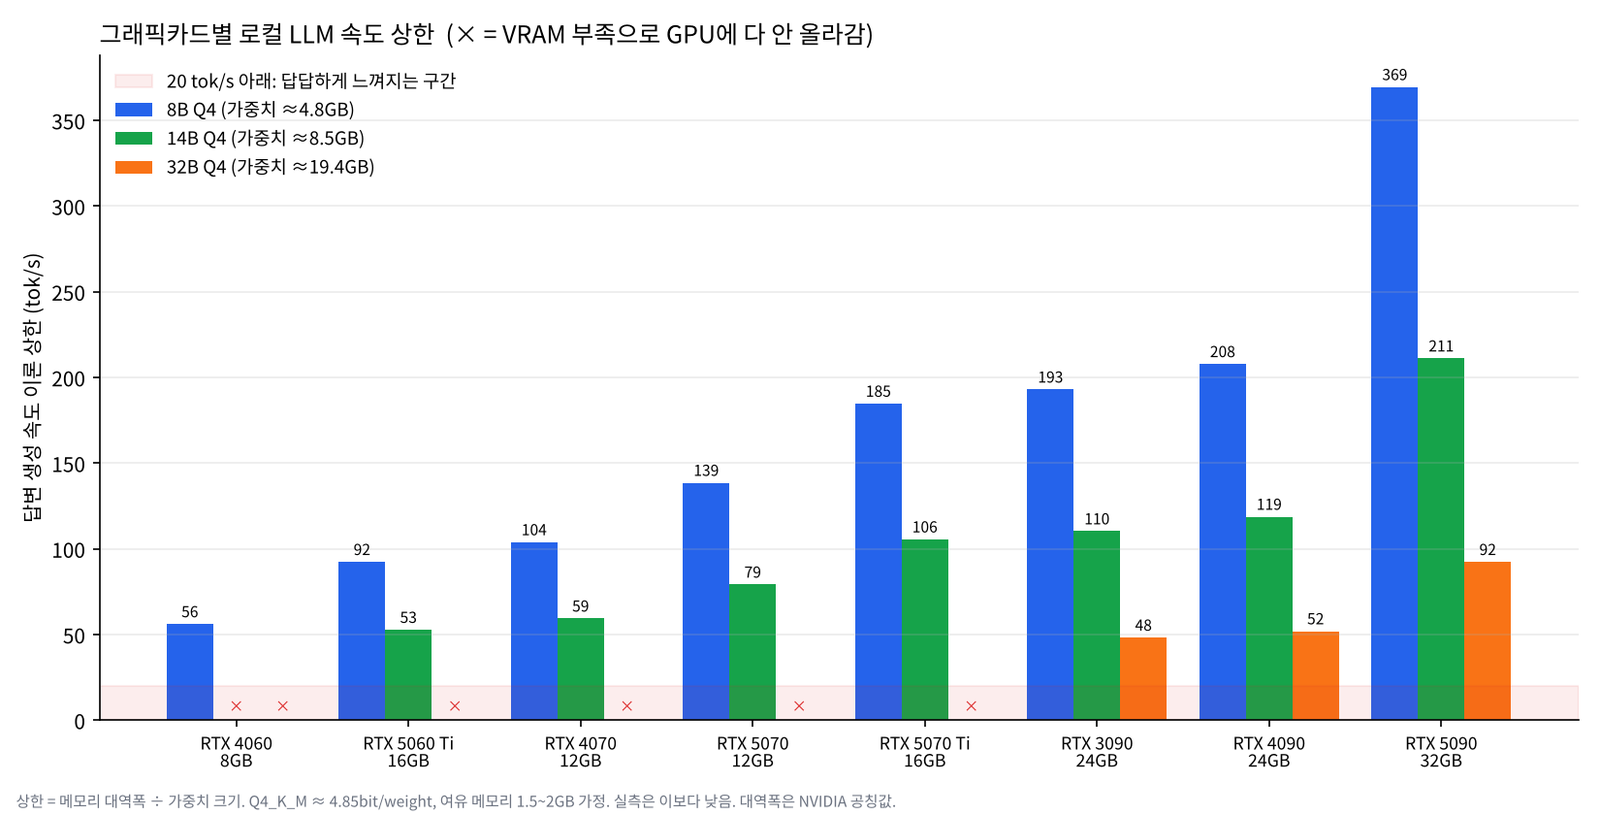
카드 | VRAM / 대역폭 | 8B | 14B | 32B |
|---|---|---|---|---|
RTX 4060 | 8GB / 272GB/s | 56 | – | – |
RTX 5060 Ti 16GB | 16GB / 448GB/s | 92 | 53 | – |
RTX 4070 | 12GB / 504GB/s | 104 | 59 | – |
RTX 5070 | 12GB / 672GB/s | 139 | 79 | – |
RTX 5070 Ti | 16GB / 896GB/s | 185 | 106 | – |
RTX 3090 | 24GB / 936GB/s | 193 | 110 | 48 |
RTX 4090 | 24GB / 1,008GB/s | 208 | 119 | 52 |
RTX 5090 | 32GB / 1,792GB/s | 369 | 211 | 92 |
(단위: tok/s 이론 상한, – 는 VRAM 부족)
실제 속도는 이 상한보다 낮게 나옵니다. 대화가 길어지면 기억 공간(KV 캐시)도 매번 읽어야 하고, 프로그램(llama.cpp, vLLM 등)마다 효율도 다르기 때문입니다. 그래도 카드끼리 비교하는 기준으로는 충분히 쓸 만합니다.
체감 기준도 하나 드리면, 경험상 초당 20토큰 정도를 넘으면 사람이 읽는 속도보다 빨라서 답답함을 거의 느끼지 않습니다. 그래서 위 숫자가 모두 충분히 빨라 보이지만, 실제로는 긴 대화나 긴 문서에서 속도가 꽤 떨어집니다. 상한에 여유가 있는 카드일수록 실사용에서 쾌적합니다.
4. 지금 가격 상황 (2026년 11월 초, 국내 기준)
추천 전에 꼭 짚어야 할 부분이 있습니다. 2026년 들어 메모리 공급 부족으로 그래픽카드 가격이 크게 올랐고, 특히 VRAM이 많은 고급형일수록 더 많이 올랐습니다.
카드 | 국내 가격 | VRAM 1GB당 |
|---|---|---|
RTX 5060 Ti 16GB | 다나와 최저 약 86만원 | 약 5.4만원 |
RTX 5070 12GB | 다나와 최저 약 101만원 | 약 8.4만원 |
RTX 5070 Ti 16GB | 10월 평균 판매가 약 189만원 | 약 11.8만원 |
RTX 5080 16GB | 10월 평균 판매가 약 250만원 | 약 15.6만원 |
RTX 5090 32GB | 10월 평균 판매가 약 976만원 (최저가도 1,000만원대) | 약 30만원 이상 |
중고 RTX 3090 24GB | 중고 판매 글 기준 약 160만~200만원 | 약 7~8만원 |
(최저가는 11월 10일 다나와 검색 기준, 평균 판매가는 다나와의 10월 판매 데이터 분석 기준입니다.)
다나와 분석에 따르면 올해 1월 대비 10월 평균 판매가가 RTX 5090은 86.2%, RTX 5070은 29.0%, RTX 5070 Ti는 28.9%, RTX 5060 Ti는 16.2% 올랐습니다. 가격은 매일 바뀌니 구매 직전에 꼭 다시 확인하시길 바랍니다. 중고 3090은 상태와 모델에 따라 차이가 크고, 매입 희망가는 110만~130만원대에 형성돼 있습니다.
이 상황에서는 "VRAM 1GB당 가격"으로 비교하는 것이 가장 합리적입니다. 표의 오른쪽 열을 보면 16GB에서는 RTX 5060 Ti가 가장 저렴하고, 24GB 이상에서는 중고 3090이 압도적으로 저렴합니다.
5. 그래서 제 추천은
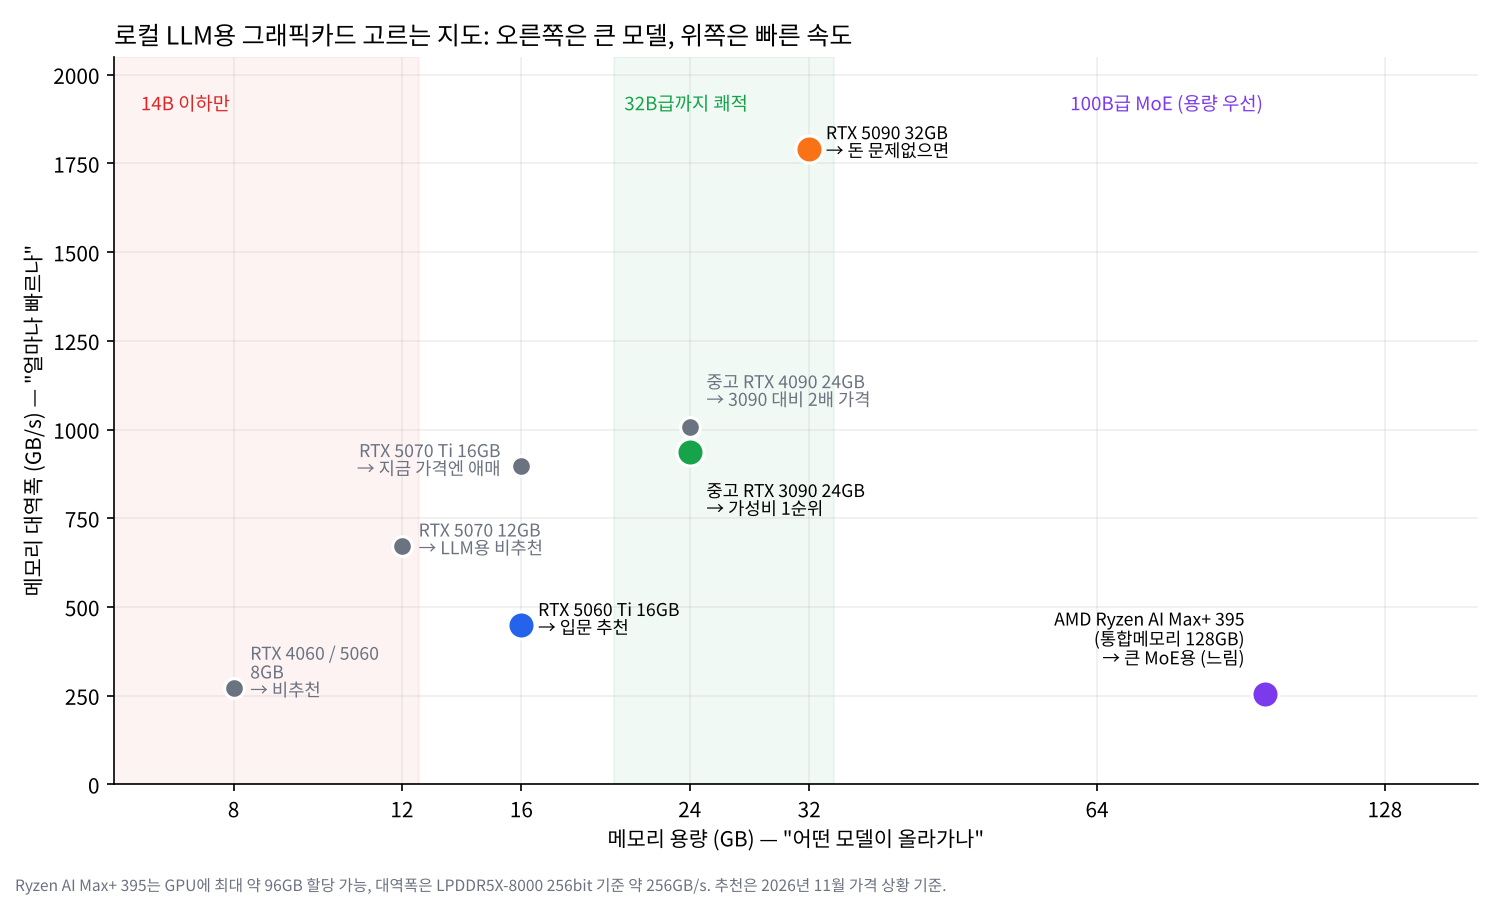
1) 처음 시작하는 분: RTX 5060 Ti 16GB
대역폭은 낮은 편이지만, 이 가격대에서 16GB를 주는 신품은 사실상 이 카드뿐입니다. 14B 모델까지 쾌적하게 쓸 수 있어서 로컬 LLM이 어떤 건지 경험하기에 충분합니다. 같은 이름의 8GB 모델과 헷갈리지 않도록 꼭 16GB인지 확인하세요.
2) 가성비를 따지는 분: 중고 RTX 3090 24GB (제 1순위 추천)
2020년에 나온 카드지만 LLM 기준으로는 아직도 가장 합리적인 선택입니다. 24GB라서 32B급 모델이 올라가고, 대역폭(936GB/s)도 4090과 10% 차이가 안 납니다. 새 5070 Ti 16GB(평균 약 189만원)와 가격이 비슷하거나 더 싼데 VRAM은 1.5배입니다.
중고로 사실 때 확인할 점이 있습니다.
파워서플라이는 850W 이상을 권합니다. 순간 전력 소모가 큰 카드입니다.
장시간 부하를 걸어 메모리 온도를 확인하세요. 3090은 뒷면 메모리 발열이 약점입니다.
채굴에 쓰였던 카드인지, 남은 보증 기간이 있는지 확인하세요.
FP8 같은 최신 기능은 지원하지 않습니다. 추론에는 큰 문제가 없지만 최신 학습 기법을 쓸 계획이라면 고려하세요.
3) 예산 걱정이 없는 분: RTX 5090 32GB
현재 소비자용 카드 중 가장 빠르고, 32GB라서 32B 모델에 긴 문서까지 여유 있게 올라갑니다. 다만 국내 10월 평균 판매가가 약 976만원으로, 중고 3090 다섯 대 이상 값입니다. 업무용으로 매일 쓸 게 아니라면 가격이 안정될 때까지 기다리는 것을 권합니다.
4) 100B급 MoE 모델을 돌리고 싶은 분: 통합 메모리 장비
최근 많이 나오는 MoE 모델은 전체 크기가 100B를 훌쩍 넘습니다. 그래픽카드 하나로는 올라가지 않습니다. 이럴 때는 메모리를 많이 달 수 있는 Mac이나 AMD Ryzen AI Max+ 395 계열 미니 PC가 대안입니다. 대역폭이 낮아서(Ryzen AI Max+ 395 기준 약 256GB/s) 큰 dense 모델은 느리지만, MoE 모델은 토큰마다 일부만 읽기 때문에 생각보다 쓸 만한 속도가 나옵니다. 이 원리는 5편(MoE)에서 자세히 다룹니다.
5) 피하시길 권하는 선택
8GB 카드(RTX 4060, 5060 8GB, 5060 Ti 8GB): 8B 모델이 한계라 금방 아쉬워집니다.
LLM용 RTX 5070 12GB: 게임용으로는 좋지만, LLM용으로는 5060 Ti 16GB보다 15만원 정도 비싼데 VRAM은 오히려 4GB 적습니다.
지금 가격의 RTX 5070 Ti, 5080 (16GB): 빠르긴 하지만 비싼 돈을 내고도 16GB에 묶입니다. 그 예산이면 중고 3090이 LLM에는 더 낫습니다.
6) 기다려야 할까?
VRAM을 늘린 RTX 50 Super 시리즈(예: 24GB 5070 Ti Super)가 나온다는 루머가 1년 넘게 이어지고 있습니다. 하지만 메모리 공급 문제로 연기와 취소설이 반복되고 있고, 공식 발표는 아직 없습니다. 출시를 확신하고 기다리기보다는, 지금 필요하다면 위 기준으로 고르시는 편이 낫다고 봅니다.
참고로 AMD RX 7900 XTX(24GB, 960GB/s)도 VRAM과 대역폭만 보면 3090과 비슷한 위치입니다. 다만 CUDA가 아니라 ROCm이나 Vulkan으로 돌려야 해서, 쓰려는 프로그램이 지원하는지 먼저 확인하셔야 합니다.
6. 한 가지 더: 긴 문서를 넣는다면
질문에 답하는 속도와 별개로, 긴 문서를 처음 읽어 들이는 단계(프리필)는 대역폭이 아니라 그래픽카드의 계산 능력이 좌우합니다. 수십 페이지짜리 문서를 넣고 질문하는 RAG 용도라면, 첫 답변이 나오기까지의 대기 시간에서 최신 세대 카드(40·50 시리즈)가 3090보다 확실히 유리합니다.
References
Tom's Hardware, Nvidia GeForce RTX 5090 Review (RTX 5090/4090/3090 사양). https://www.tomshardware.com/pc-components/gpus/nvidia-geforce-rtx-5090-review
TechSpot, GPU Prices Are Spiraling Out of Control: Q4 2026 Update. https://www.techspot.com/article/3192-gpu-pricing-q4-2026/
다나와 DPG, 그래픽카드 1,000만원 시대, RTX 5090 최고 1,300만원 돌파… 그래픽카드 10년의 변화 (2026.11.04). https://dpg.danawa.com/news/view?boardSeq=63&listSeq=6077302
중고나라, RTX 3090 24GB 중고 거래 시세. https://web.joongna.com/search/RTX%203090%2024GB
Yuan et al., LLM Inference Unveiled: Survey and Roofline Model Insights, arXiv:2402.16363 (2024). https://arxiv.org/abs/2402.16363
llama.cpp (양자화 포맷 문서). https://github.com/ggml-org/llama.cpp