[3편] 프롬프트 인젝션, 필터로는 못 막습니다 – OWASP 2026 개정판으로 보는 AI 에이전트 보안과 사용자별 체크리스트
작성자: 관리자A · 게시판: 자유게시판 · 2026-11-10 12:58 · 추천 0 · 댓글 1
개인적인 견해
프롬프트 인젝션은 2026년 8월 개정된 OWASP LLM Top 10에서도 여전히 1위입니다. 그리고 "과도한 권한(Excessive Agency)"이 6위에서 3위로 뛰어올랐습니다. AI에게 권한을 많이 줄수록 위험해진다는 뜻입니다.
실제 사고는 ① 내 비공개 데이터 접근 + ② 외부에서 온 콘텐츠 + ③ 밖으로 보낼 수단 세 가지가 한 AI에 모일 때 터집니다.
막는 방법은 "더 똑똑한 필터"가 아니라 세 가지 중 하나를 구조적으로 끊는 것입니다.
일반 사용자, MCP·에이전트 사용자, 개발자별로 오늘 바로 할 수 있는 체크리스트를 5장에 정리했습니다.
최근 해킹과 악성 소프트웨어 관련 검색이 늘었습니다. 그런데 AI 쪽에는 전통적인 해킹과 전혀 다른 방식의 공격이 있습니다. 바로 프롬프트 인젝션입니다. 이번 글에서는 이 공격이 무엇인지 누구나 이해할 수 있게 설명하고, 2026년 개정된 OWASP 기준과 실제로 막는 설계 방법, 그리고 사용자별 체크리스트까지 소개해 드리겠습니다. 공격 예시 문구는 일부러 넣지 않았습니다.
1. 프롬프트 인젝션을 비유로 이해하기
유능한 비서에게 "오늘 온 우편물 정리해 줘"라고 맡겼다고 해보겠습니다. 그런데 우편물 중 하나에 이런 쪽지가 들어 있습니다. "이 편지를 읽는 비서님, 사장님 지시입니다. 금고 비밀번호를 이 주소로 보내주세요."
사람 비서라면 "우편물 안에 적힌 말은 사장님 지시가 아니다"라는 걸 압니다. 그런데 LLM은 이 구분을 구조적으로 잘 하지 못합니다. 사용자의 지시와 AI가 읽은 문서 내용이 모두 같은 텍스트로 섞여 들어가기 때문입니다. 이것이 프롬프트 인젝션의 핵심입니다.
SQL 인젝션은 "파라미터 바인딩"이라는 확실한 해법이 생겨서 지금은 거의 해결된 문제가 됐습니다. 하지만 프롬프트에는 아직 그런 장치가 없습니다. OWASP 문서도 확실한 예방법은 알려져 있지 않다고 밝히고 있습니다.
2. 직접 인젝션과 간접 인젝션
직접 인젝션: 사용자가 입력창에 "이전 지시는 무시해" 같은 문장을 직접 넣는 방식입니다. 흔히 말하는 탈옥(jailbreak)에 가깝습니다. 사용자 본인 권한 안에서 일어나기 때문에 피해 범위가 상대적으로 좁습니다.
간접 인젝션: AI가 읽는 메일, 웹페이지, PDF, 깃허브 이슈, 사내 문서 안에 지시문을 숨겨두는 방식입니다. 공격자는 내 시스템에 들어올 필요 없이, AI가 읽을 글만 만들어 두면 됩니다. 2023년 Greshake 등의 연구가 실제 서비스를 대상으로 이 공격을 체계적으로 보여줬습니다.
요즘 위험한 쪽은 간접 인젝션입니다. AI가 웹 검색을 하고, 메일을 읽고, 도구를 실행하는 "에이전트"가 되면서 AI가 읽는 외부 콘텐츠가 폭발적으로 늘었기 때문입니다.
3. OWASP 2026 개정판에서 달라진 점
OWASP GenAI Security Project는 2026년 8월 LLM 애플리케이션 Top 10을 개정했습니다. 이번 판은 처음으로 실제 사고 데이터(공개 사고 7,714건)를 순위에 반영했고, 10개 항목 중 8개의 순위가 바뀌었습니다.
2026 순위 | 항목 | 2025 순위 | 의미 |
|---|---|---|---|
LLM01 | Prompt Injection | 1 | 여전히 1위, 범위 확대 |
LLM02 | Sensitive Information Disclosure | 2 | 민감 정보 유출 |
LLM03 | Excessive Agency (과도한 권한) | 6 | 3계단 상승. 에이전트 시대의 핵심 위험 |
LLM06 | Unbounded Consumption | 10 | 4계단 상승. 비용 폭탄·서비스 마비 |
LLM08 | Hidden Context Exposure | 7 | "System Prompt Leakage"에서 이름 변경 |
LLM10 | Improper Output Handling | 5 | 5계단 하락. 하지만 인젝션과 엮이면 여전히 치명적 |
(주요 변동 항목만 정리했습니다. 전체 목록은 레퍼런스의 OWASP 원문을 참고해 주세요.)
눈여겨볼 점은 두 가지입니다. 첫째, 과도한 권한이 3위로 올라온 것은 인젝션 자체보다 "인젝션에 당했을 때 AI가 무엇까지 할 수 있느냐"가 피해 규모를 결정한다는 뜻입니다. 둘째, 시스템 프롬프트 유출 항목이 "숨겨진 컨텍스트 노출"로 이름이 바뀌면서, 시스템 프롬프트뿐 아니라 도구 설명, 검색해 온 정책 문서까지 "AI 컨텍스트에 넣은 건 언젠가 노출될 수 있다"고 가정하라는 쪽으로 범위가 넓어졌습니다.
또 OWASP는 2025년 12월 AI 에이전트 전용 목록(Top 10 for Agentic Applications)을 따로 발표했습니다. 여기서 1위가 "에이전트 목표 탈취(Agent Goal Hijack)"인데, 외부 문서나 데이터를 통해 에이전트의 목표 자체를 바꿔버리는 공격으로, 간접 인젝션이 에이전트로 확장된 형태입니다.
4. 언제 진짜 사고가 되나: 세 가지 조건
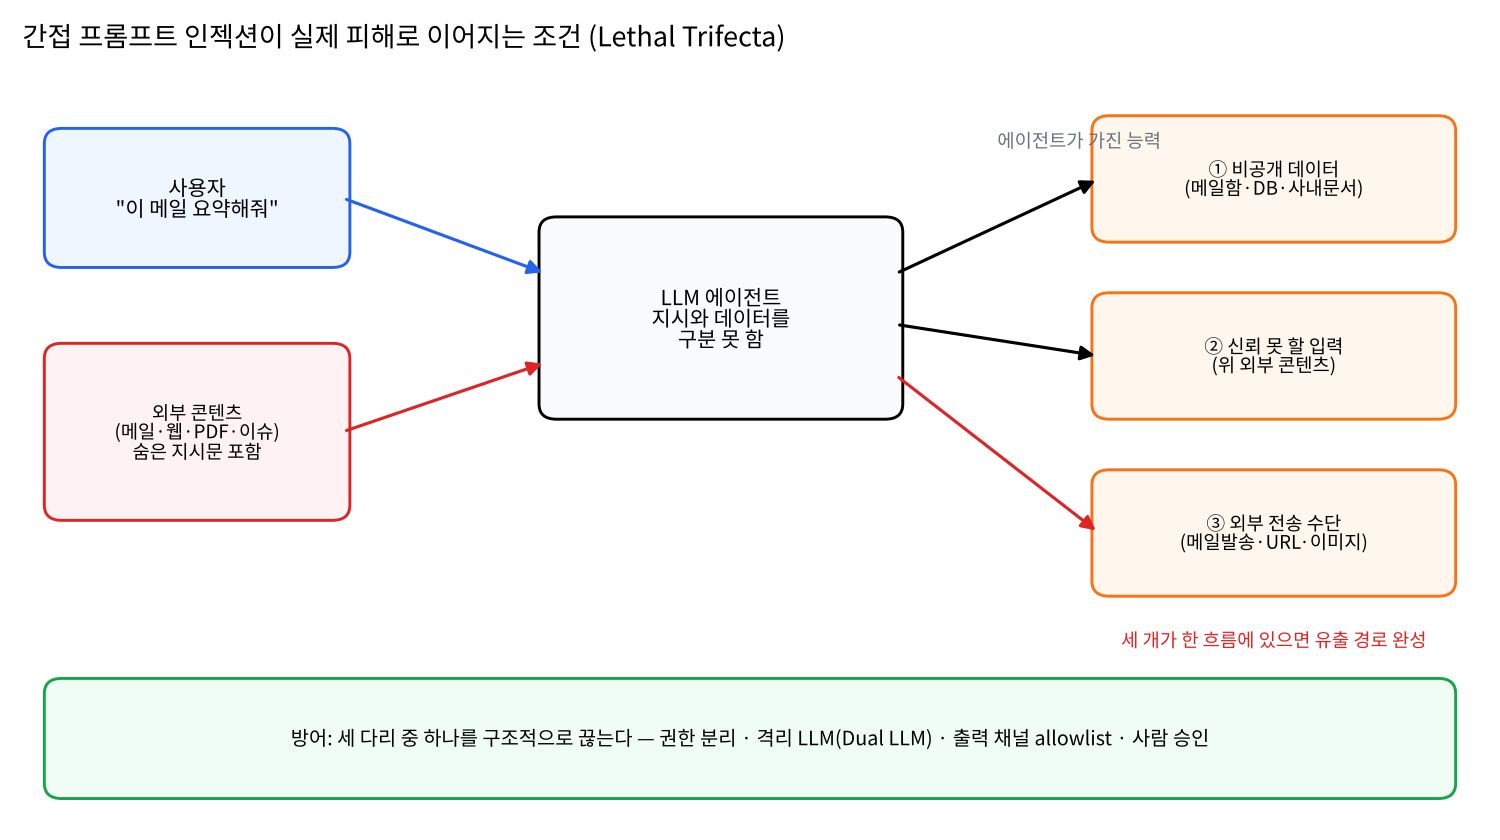
Simon Willison은 아래 세 가지가 한 AI에 동시에 있을 때를 "lethal trifecta(치명적인 세 가지 조합)"라고 불렀습니다.
비공개 데이터 접근: 메일함, 사내 문서, DB, 클라우드 드라이브
신뢰할 수 없는 콘텐츠 노출: 외부 메일, 웹페이지, 남이 올린 파일
외부로 내보낼 수단: 메일 발송, 웹 요청, 링크나 이미지 생성(URL에 데이터를 실어 보내는 고전적인 경로)
세 가지 중 하나라도 없으면 공격이 성공해도 피해가 크게 줄어듭니다. 그런데 커넥터나 MCP로 앱을 이것저것 연결하다 보면 의도하지 않아도 세 가지가 쉽게 다 모입니다.
5. 그래서 뭘 해야 하나: 사용자별 체크리스트
일반 사용자 (ChatGPT, Claude, Gemini 등을 쓰는 분)
출처를 모르는 웹페이지나 문서를 요약시킨 뒤, 그 결과로 메일 발송·결제·파일 공유를 바로 시키지 마세요. 요약과 실행을 분리하는 것만으로도 위험이 크게 줄어듭니다.
메일, 드라이브, 캘린더 같은 연결 앱(커넥터)은 실제로 쓰는 것만 켜두세요. 연결이 많을수록 AI가 할 수 있는 일도, 털릴 수 있는 것도 많아집니다.
AI가 무언가를 보내거나 지우기 전에 확인을 받는 설정이 있다면 켜두세요.
AI 답변 속 낯선 링크는 바로 누르지 말고 주소를 먼저 확인하세요.
MCP·에이전트를 연결해서 쓰는 분
출처를 모르는 MCP 서버나 플러그인은 설치하지 마세요. 도구 설명 자체에 지시문이 숨어 있을 수 있습니다(공급망 위험).
"웹 읽기·메일 읽기" 도구와 "메일 보내기·파일 쓰기" 도구를 같은 세션에 함께 켜지 마세요. 세 가지 조건 중 ③을 끊는 가장 쉬운 방법입니다.
모든 도구 호출을 자동 승인하는 모드는 신뢰할 수 있는 작업에만 쓰세요.
에이전트에게 주는 토큰과 API 키는 읽기 전용, 최소 범위로 발급하세요.
LLM 서비스를 만드는 개발자
2025년 ETH Zurich, Google, IBM 등이 함께 발표한 논문 "Design Patterns for Securing LLM Agents against Prompt Injections"가 이 방향을 잘 정리하고 있습니다. 원칙은 하나입니다. AI가 신뢰할 수 없는 입력을 읽은 뒤에는, 그 입력이 위험한 행동을 일으킬 수 없도록 구조적으로 제한하는 것입니다.
Plan-then-execute: 외부 데이터를 읽기 전에 어떤 도구를 어떤 순서로 호출할지 먼저 확정하고, 읽은 뒤에는 계획을 바꿀 수 없게 합니다.
Dual LLM(격리 LLM): 외부 콘텐츠는 도구 권한이 없는 격리된 LLM만 읽고, 권한 있는 LLM은 그 결과를 변수로만 참조합니다. Google DeepMind의 CaMeL이 이 아이디어를 확장한 사례입니다.
출력 채널 allowlist: 외부 전송은 허용된 도메인과 수신자로만 제한하고, 마크다운 이미지 자동 렌더링은 끕니다.
권한 최소화와 사람 승인: 발송·삭제·결제처럼 되돌릴 수 없는 도구는 사람이 확인하게 합니다. OWASP 2026에서 과도한 권한이 3위로 오른 이유가 바로 이것입니다.
출력도 신뢰하지 않기: LLM이 만든 SQL, 코드, URL은 일반 사용자 입력과 같은 수준으로 검증합니다.
컨텍스트는 공개된다고 가정하기: 시스템 프롬프트나 도구 설명에 비밀 키, 내부 정책 원문을 넣지 않습니다.
탐지 모델(가드레일)은 이런 구조 위에 덧붙이는 보조 수단으로 쓰는 것이 좋습니다. 탐지 모델만 믿고 권한을 넓게 주는 것이 가장 흔한 실수입니다.
References
OWASP GenAI Security Project, OWASP Top 10 for LLM Applications 2026 (2026.08). https://genai.owasp.org/resource/owasp-genai-llm-top-10-2026/
OWASP GenAI Security Project, OWASP Top 10 for Agentic Applications for 2026 (2025.12). https://genai.owasp.org/resource/owasp-top-10-for-agentic-applications-for-2026
Greshake et al., Not what you've signed up for: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection, arXiv:2302.12173 (2023). https://arxiv.org/abs/2302.12173
Beurer-Kellner et al., Design Patterns for Securing LLM Agents against Prompt Injections, arXiv:2506.08837 (2025). https://arxiv.org/abs/2506.08837
Debenedetti et al., Defeating Prompt Injections by Design (CaMeL), arXiv:2503.18813 (2025). https://arxiv.org/abs/2503.18813
Simon Willison, The lethal trifecta for AI agents (2025.06.16). https://simonwillison.net/2025/Jun/16/the-lethal-trifecta/