[4편] 젠슨황과 SK하이닉스가 왜 같이 검색될까? – LLM 속도를 결정하는 HBM과 '메모리 병목' 쉽게 이해하기
작성자: 관리자A · 게시판: 자유게시판 · 2026-11-10 13:01 · 추천 0 · 댓글 1
개인적인 견해
LLM이 답변을 만드는 속도는 GPU의 계산 능력보다 메모리에서 데이터를 퍼오는 속도(메모리 대역폭)가 결정하는 경우가 대부분입니다.
그 메모리가 바로 HBM이고, HBM을 만드는 곳이 SK하이닉스·삼성전자·마이크론입니다. 그래서 엔비디아 소식이 나올 때마다 메모리 회사가 함께 검색됩니다.
API 가격에서 출력 토큰이 입력 토큰보다 비싼 이유도 같은 원리입니다. 이걸 알면 API 비용과 로컬 LLM 속도를 아끼는 방법도 보입니다(5장).
※ 기술을 설명하는 글이며, 투자 조언이 아닙니다.
이번 주 젠슨황과 SK하이닉스 검색량이 크게 늘었습니다. 둘이 같이 오르내리는 이유는 단순히 "거래 관계"라서가 아니라, LLM이라는 기술 자체의 구조에 있습니다. 이번 글에서는 그 구조를 누구나 이해할 수 있게 설명하고, 이 원리가 API를 쓰거나 로컬 LLM을 돌리는 우리에게 어떤 의미인지까지 소개해 드리겠습니다.
1. 비유로 이해하기: 요리사와 냉장고
GPU를 엄청나게 빠른 요리사라고 생각해 보겠습니다. 이 요리사는 1초에 재료 수천 개를 손질할 수 있습니다. 그런데 재료는 냉장고에 있고, 냉장고 문이 좁아서 한 번에 꺼낼 수 있는 양이 정해져 있습니다.
요리사가 아무리 빨라도 재료가 늦게 나오면 손을 놓고 기다릴 수밖에 없습니다. 여기서 요리사의 손 속도가 GPU의 계산 능력(TFLOPS), 냉장고 문 크기가 메모리 대역폭(TB/s)입니다.
LLM은 단어(토큰) 하나를 쓸 때마다 모델 전체, 즉 냉장고 안의 재료 전부를 한 번씩 꺼내 봐야 합니다. 그래서 답변을 한 글자씩 만드는 동안 GPU는 대부분의 시간을 기다리며 보냅니다. 이것을 "메모리 병목"이라고 부릅니다.
2. 숫자로 확인하기: 루프라인 모델
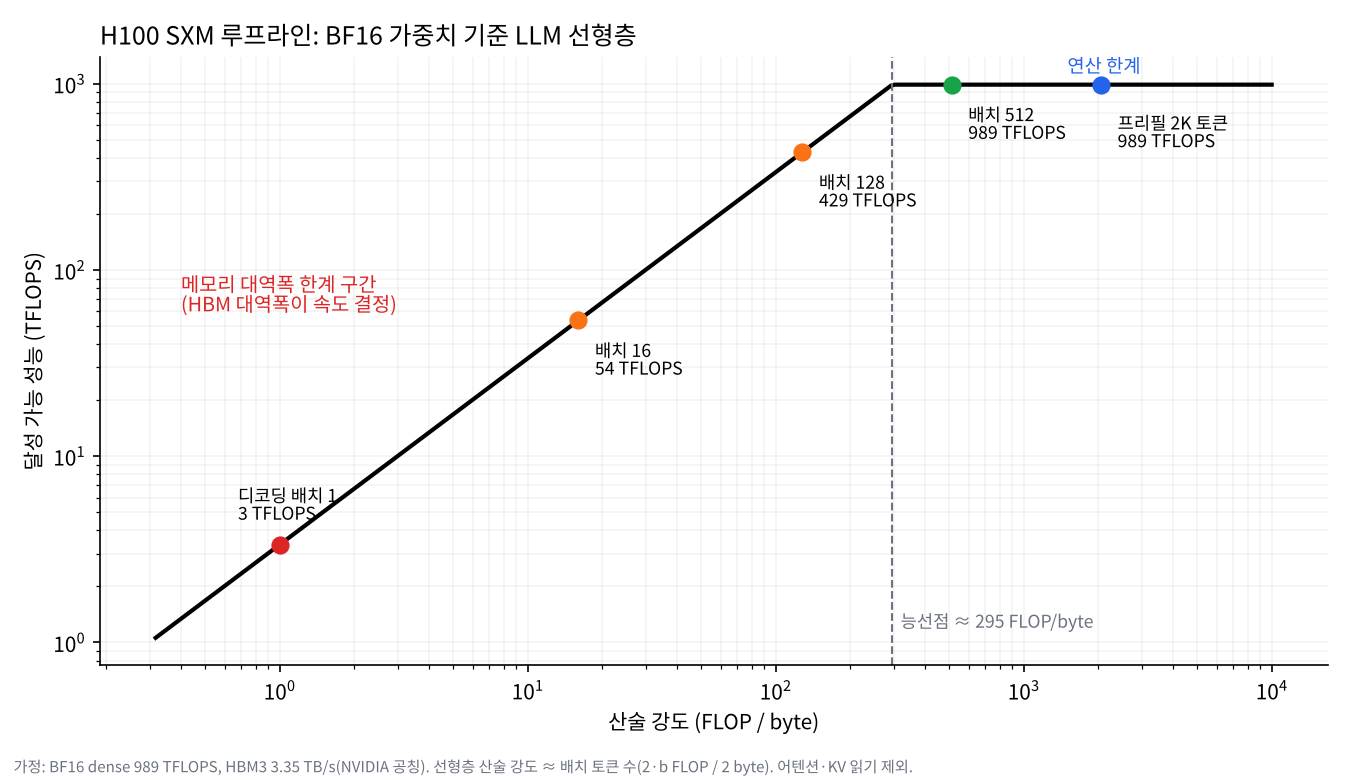
이 관계를 그래프로 그린 것이 "루프라인(Roofline) 모델"입니다. 하드웨어 성능의 상한은 두 개의 천장으로 정해집니다.
달성 가능 성능 = min(피크 연산 성능, 메모리 대역폭 × 산술 강도)
산술 강도 = 연산량(FLOP) ÷ 메모리에서 읽은 데이터 양(byte)
산술 강도는 "재료 1g을 꺼냈을 때 얼마나 많은 요리를 하느냐"입니다. 이 값이 낮으면 냉장고 문(메모리)에, 높으면 요리사 손(연산)에 성능이 묶입니다. 두 직선이 만나는 지점을 능선점(ridge point)이라고 합니다.
엔비디아 H100(BF16 약 989TFLOPS, 메모리 대역폭 3.35TB/s)으로 계산하면 능선점은 약 295FLOP/byte입니다. 즉 메모리에서 1byte를 읽을 때마다 295번 이상 계산해야 GPU를 꽉 채워 쓸 수 있습니다.
그런데 LLM이 답변을 만들 때(디코딩), 한 번에 요청 1개를 처리하면 산술 강도는 약 1FLOP/byte에 불과합니다. 가중치 1개(2byte)를 읽어서 곱셈·덧셈 2번만 하기 때문입니다. 여러 요청을 묶어서 한 번에 처리하면(배치) 같은 가중치로 여러 계산을 하니 산술 강도가 배치 크기만큼 올라갑니다.
상황 | 산술 강도 | 달성 가능 성능 | 피크 대비 |
|---|---|---|---|
디코딩, 요청 1개 | 약 1 | 약 3.4 TFLOPS | 0.3% |
디코딩, 요청 16개 묶음 | 약 16 | 약 54 TFLOPS | 5% |
디코딩, 요청 128개 묶음 | 약 128 | 약 429 TFLOPS | 43% |
디코딩, 요청 512개 묶음 | 약 512 | 989 TFLOPS | 100% |
프롬프트 읽기(프리필), 2천 토큰 | 약 2,048 | 989 TFLOPS | 100% |
요청 1개만 처리하면 H100의 계산 능력 중 0.3%만 쓰고 나머지는 놉니다. 반면 질문을 처음 읽어 들이는 단계(프리필)는 수천 토큰을 한 번에 처리하므로 처음부터 계산 능력을 꽉 채웁니다.
(참고로 어텐션 부분은 요청마다 각자의 대화 기억(KV 캐시)을 읽기 때문에 배치를 키워도 산술 강도가 오르지 않습니다. 대화가 길수록 이 부분이 또 하나의 메모리 병목이 됩니다. 1편의 KV 캐시 계산과 이어지는 내용입니다.)
3. 그래서 HBM이 중요합니다
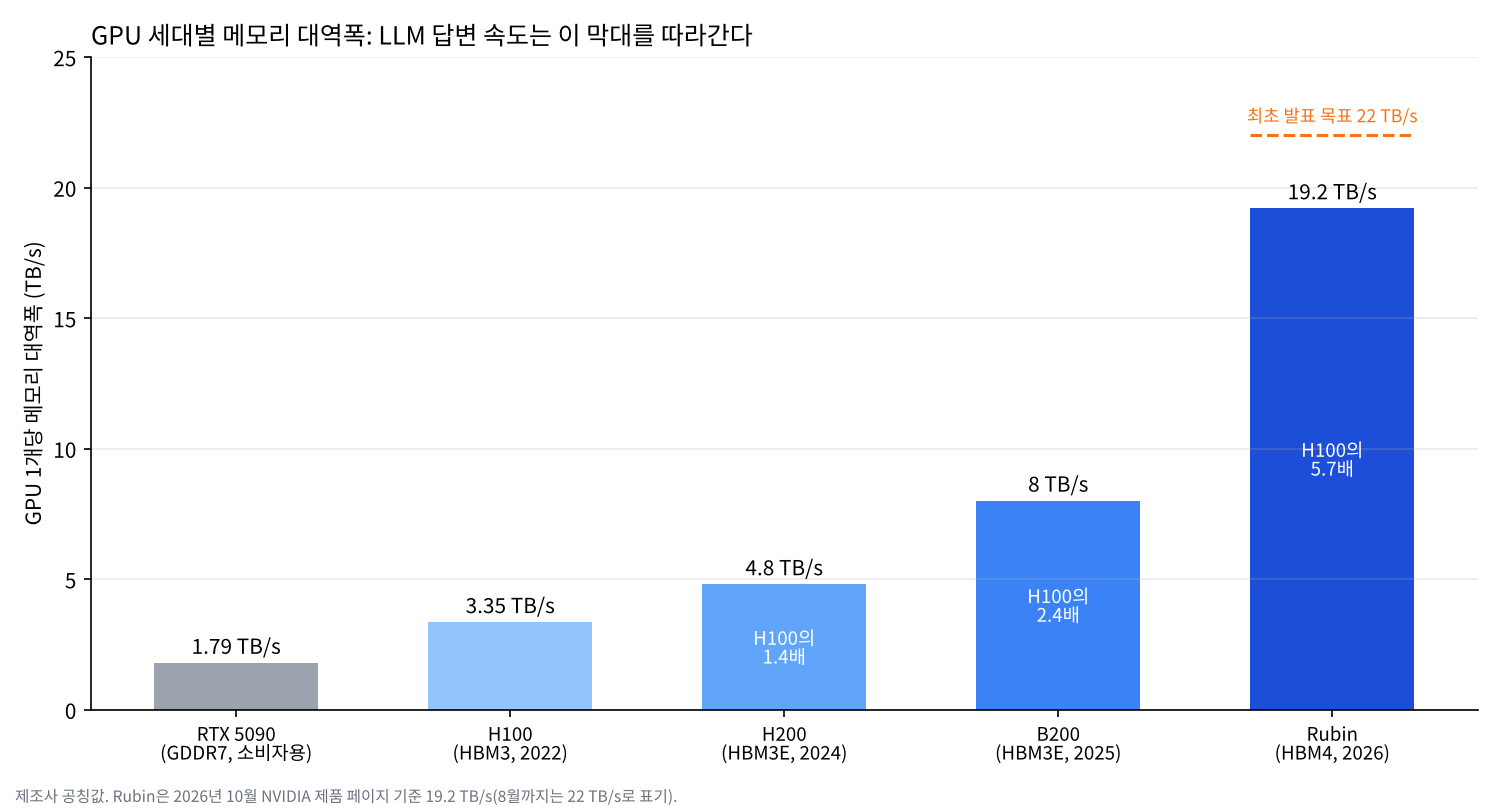
디코딩이 메모리에 묶여 있으니, GPU 세대가 바뀔 때 LLM 답변 속도는 계산 능력보다 메모리 대역폭을 따라갑니다. 그리고 데이터센터 GPU의 메모리 대역폭을 책임지는 것이 HBM(High Bandwidth Memory)입니다. D램을 수직으로 쌓아 GPU 바로 옆에 붙인 메모리로, 일반 그래픽카드 메모리(GDDR)보다 훨씬 넓은 통로를 가지고 있습니다.
GPU | 메모리 | GPU당 대역폭 | H100 대비 |
|---|---|---|---|
RTX 5090 (소비자용) | GDDR7 32GB | 1.79 TB/s | 0.5배 |
H100 | HBM3 80GB | 3.35 TB/s | 1배 |
H200 | HBM3E 141GB | 4.8 TB/s | 1.4배 |
B200 | HBM3E 192GB | 8 TB/s | 2.4배 |
Rubin (2026) | HBM4 288GB | 19.2 TB/s | 5.7배 |
HBM4는 2025년 4월 JEDEC 표준으로 확정됐고, 데이터 통로 폭을 2,048bit로 이전 세대의 두 배로 늘린 것이 핵심입니다. 엔비디아의 차세대 GPU 루빈(Rubin)이 이 HBM4를 GPU당 288GB 탑재합니다.
흥미로운 점이 하나 있습니다. 엔비디아는 루빈의 메모리 대역폭을 처음에 GPU당 22TB/s로 발표했는데, 2026년 10월 공식 제품 페이지에서는 19.2TB/s로 낮춰 표기했습니다. 업계에서는 목표 속도를 맞추는 HBM4 물량이 부족해, 기준을 낮춰 생산량을 확보하려는 것으로 보고 있습니다. 그만큼 지금 AI 업계의 병목이 메모리라는 뜻입니다.
4. 메모리 업계는 지금
점유율: 시장조사업체 카운터포인트에 따르면 2026년 2분기 HBM 시장 점유율은 SK하이닉스 50%, 삼성전자 33%, 마이크론 18%입니다. SK하이닉스가 1위를 유지하고 있지만, 1분기 58%에서 내려왔습니다.
HBM4 경쟁: 삼성전자가 2026년 2월 HBM4 양산 출하를 가장 먼저 발표했고, SK하이닉스는 16단(스택당 48GB) HBM4를 루빈용으로 대량 출하하고 있는 것으로 알려졌습니다. HBM은 세대가 바뀔 때마다 1위가 흔들리는 시장이라, 엔비디아 발표가 나올 때마다 두 회사가 함께 검색되는 것입니다.
우리와의 연결고리: 메모리 회사들이 생산 능력을 HBM에 집중하면서 일반 D램과 그래픽카드 메모리(GDDR7) 공급도 빠듯해졌습니다. 2편에서 다룬 그래픽카드 가격 급등도 같은 흐름에 있습니다.
5. 그래서 우리한테 무슨 의미가 있나
API를 쓰는 분: 출력 토큰이 비싼 이유와 아끼는 법
대부분의 LLM API는 출력 토큰을 입력 토큰보다 몇 배 비싸게 받습니다. 이제 이유가 보입니다. 입력(프리필)은 GPU를 꽉 채워 쓰지만, 출력(디코딩)은 토큰마다 메모리를 다시 읽어야 해서 GPU 시간당 처리량이 낮기 때문입니다.
출력을 짧게 요청하세요. "핵심만 3줄로", "JSON만 출력" 같은 지시가 비용을 가장 직접적으로 줄입니다.
반복되는 입력은 캐싱을 활용하세요. 같은 시스템 프롬프트나 문서를 반복해서 보낸다면, 프롬프트 캐싱 할인을 제공하는 API가 많습니다.
급하지 않은 작업은 배치 API로 보내세요. 서버 입장에서는 요청을 많이 묶을수록 효율이 올라가기 때문에, 배치 처리를 할인해 주는 곳이 많습니다.
로컬 LLM을 돌리는 분: 속도를 올리는 법
양자화: 모델을 4bit로 줄이면 읽어야 할 양이 BF16 대비 약 4분의 1로 줄어 속도가 거의 그만큼 빨라집니다.
여러 요청을 동시에 처리하기: vLLM 같은 서버는 요청을 자동으로 묶어 처리합니다. 요청 하나의 속도는 같아도 전체 처리량은 크게 늘어납니다.
추측 디코딩(speculative decoding): 작은 모델이 여러 토큰을 미리 써보고, 큰 모델이 한 번에 검증하는 방식입니다. 큰 모델 입장에서는 놀던 계산 능력으로 여러 토큰을 동시에 검증하는 셈이라, 메모리 읽기 횟수는 그대로인데 토큰은 여러 개 나옵니다.
KV 캐시 양자화: 긴 대화에서 매번 읽는 대화 기억의 크기를 줄여, 대화가 길어질수록 느려지는 현상을 완화합니다.
6. 한 줄 정리
LLM 시대의 성능은 "얼마나 빨리 계산하느냐"보다 "얼마나 빨리 퍼오느냐"가 결정합니다. 젠슨황과 SK하이닉스가 같이 검색되는 건 그래서 자연스러운 일입니다.
References
Williams, Waterman, Patterson, Roofline: An Insightful Visual Performance Model for Multicore Architectures, CACM 52(4), 2009. https://doi.org/10.1145/1498765.1498785
Yuan et al., LLM Inference Unveiled: Survey and Roofline Model Insights, arXiv:2402.16363 (2024). https://arxiv.org/abs/2402.16363
NVIDIA, H100 Tensor Core GPU. https://www.nvidia.com/en-us/data-center/h100/
FourWeekMBA, Nvidia Cuts Vera Rubin Memory Bandwidth to 19.2 TB/s per GPU (2026.10). https://fourweekmba.com/ai-nvidia-cuts-vera-rubin-memory-bandwidth-to-19-2-tb-s-per-gpu/
Counterpoint Research, Global DRAM and HBM Market Share: Quarterly. https://counterpointresearch.com/insights/global-dram-and-hbm-market-share
All About Circuits, JEDEC Officially Releases HBM4 Memory Standard (2025.04). https://www.allaboutcircuits.com/news/jedec-officially-releases-hbm4-memory-standard
Leviathan, Kalman, Matias, Fast Inference from Transformers via Speculative Decoding, arXiv:2211.17192 (2022). https://arxiv.org/abs/2211.17192