[5편] "활성 23B인데 왜 VRAM 140GB?" – MoE 모델의 메모리와 속도, 그리고 내 장비로 돌릴 수 있는 MoE 모델 정리
작성자: 관리자A · 게시판: 자유게시판 · 2026-11-10 13:12 · 추천 0 · 댓글 1
개인적인 견해
MoE 모델은 숫자가 두 개입니다. 메모리에 올려야 하는 양은 "전체 파라미터", 답변 속도는 "활성 파라미터"가 정합니다.
그래서 "A23B면 23B 모델처럼 가볍겠지"는 절반만 맞는 말입니다. 속도는 23B급이지만, 메모리는 236B를 다 올려야 합니다.
요즘 나오는 큰 오픈 모델은 대부분 MoE입니다. 그래서 MoE는 그래픽카드 VRAM보다 "메모리를 많이 달 수 있는 장비"와 궁합이 좋습니다.
16GB, 24GB, 128GB 통합 메모리 장비별로 실제로 돌릴 만한 MoE 모델을 4장에 정리했습니다.
"Qwen3.6-35B-A3B", "K-EXAONE-236B-A23B"처럼 요즘 모델 이름 뒤에 "A숫자B"가 붙은 걸 자주 보셨을 겁니다. 이게 MoE(Mixture of Experts) 모델의 "활성 파라미터"입니다. 이번 글에서는 MoE가 무엇인지, 왜 메모리는 많이 먹는데 속도는 빠른지, 그리고 내 장비로는 어떤 MoE 모델을 돌릴 수 있는지까지 소개해 드리겠습니다.
1. 비유로 이해하기: 전문의가 많은 대형 병원
MoE 모델은 전문의가 128명 있는 대형 병원과 비슷합니다. 환자(토큰)가 오면 접수처(라우터)가 증상을 보고 그 환자에게 맞는 전문의 몇 명에게만 보냅니다. 128명이 전부 진료하지 않으니 한 환자를 진료하는 데 드는 시간이 짧습니다. 이것이 "활성 파라미터"이고, MoE가 빠른 이유입니다.
그런데 문제가 있습니다. 다음 환자가 어떤 증상일지 미리 알 수 없습니다. 그래서 128명의 전문의가 모두 병원에 출근해 있어야 합니다. 이것이 "전체 파라미터"이고, MoE가 메모리를 많이 먹는 이유입니다.
반대로 일반 모델(Dense)은 모든 의사가 모든 환자를 같이 보는 작은 병원입니다. 출근 인원과 진료 인원이 같습니다.
2. 두 숫자를 따로 계산하기
2편에서 소개한 두 공식을 그대로 쓰되, 숫자를 다르게 넣으면 됩니다. 4bit 양자화(Q4_K_M, 파라미터당 약 0.6byte) 기준입니다.
필요한 메모리 ≈ 전체 파라미터(B) × 0.6GB + 여유분
속도 상한(tok/s) ≈ 메모리 대역폭(GB/s) ÷ (활성 파라미터(B) × 0.6GB)
K-EXAONE-236B-A23B와 일반 32B 모델을 비교해 보겠습니다.
Dense 32B | MoE 236B-A23B (K-EXAONE) | |
|---|---|---|
메모리에 올려야 하는 양 | 약 19GB | 약 143GB |
토큰 1개당 읽는 양 | 약 19GB | 약 14GB |
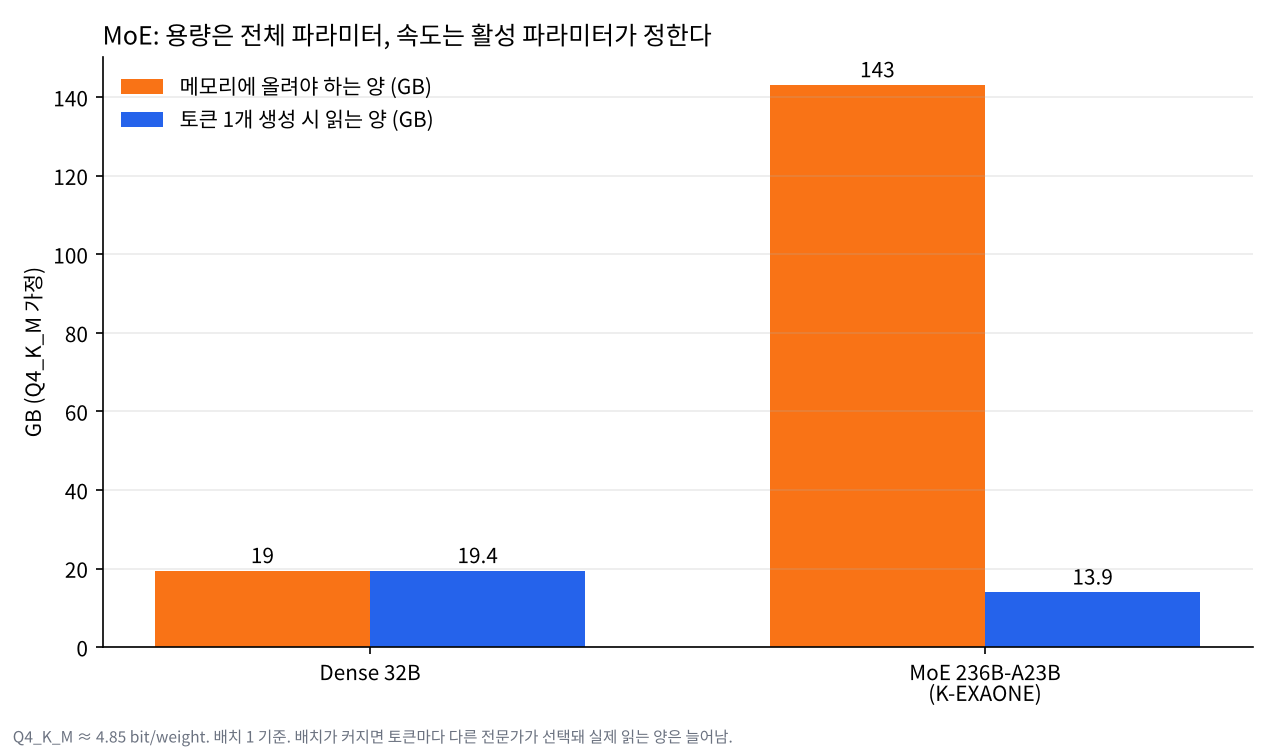
메모리는 7배 넘게 필요하지만, 토큰마다 읽는 양은 오히려 적습니다. 그래서 메모리 용량만 받쳐준다면 236B MoE가 32B 일반 모델보다 빠를 수 있습니다. 대역폭 800GB/s 장비라면 이론 상한이 MoE 약 57tok/s, 32B 일반 모델 약 41tok/s입니다.
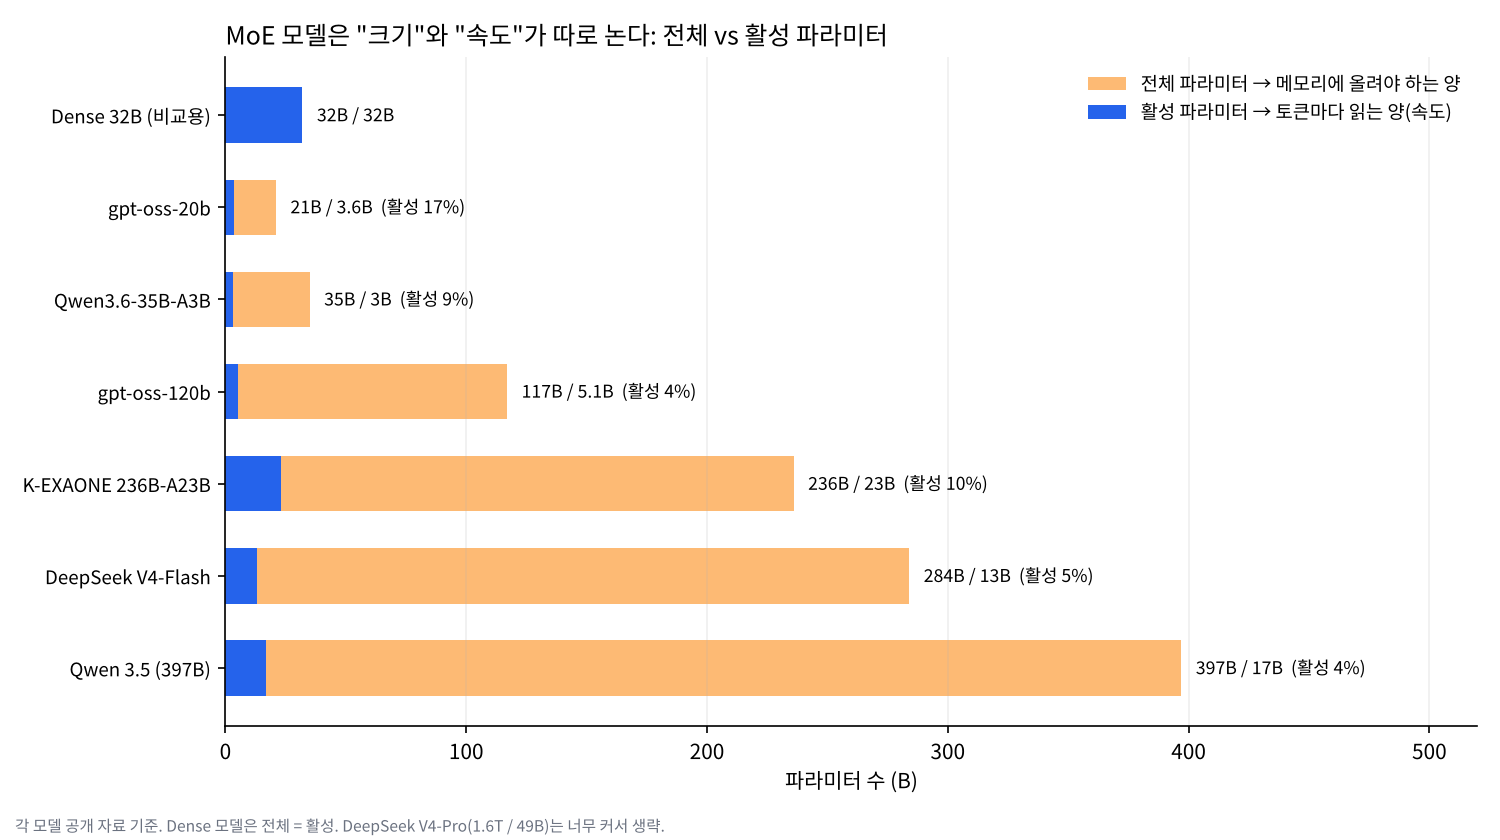
요즘 많이 쓰는 MoE 모델들도 비슷한 구조입니다.
모델 | 전체 / 활성 | 활성 비율 |
|---|---|---|
gpt-oss-20b (OpenAI) | 21B / 3.6B | 17% |
Qwen3.6-35B-A3B (Alibaba) | 35B / 3B | 9% |
gpt-oss-120b (OpenAI) | 117B / 5.1B | 4% |
K-EXAONE-236B-A23B (LG) | 236B / 23B | 10% |
DeepSeek V4-Flash | 284B / 13B | 5% |
Qwen 3.5 (397B) | 397B / 17B | 4% |
DeepSeek V4-Pro | 1.6T / 49B | 3% |
최신 큰 오픈 모델일수록 활성 비율이 5% 안팎까지 내려갑니다. "덩치는 크게, 실제 계산은 가볍게"가 요즘 모델 설계의 흐름입니다.
3. 주의할 점: 여러 명이 동시에 쓰면 달라집니다
위 계산은 요청을 하나씩 처리할 때 기준입니다. 여러 요청을 한꺼번에 처리하면 토큰마다 다른 전문가를 고르기 때문에, 한 번에 실제로 읽는 전문가 수가 빠르게 늘어납니다. 요청이 충분히 많으면 거의 모든 전문가를 매번 읽게 되고, "읽는 양이 적다"는 장점이 사라집니다.
대신 전문가마다 처리하는 토큰이 늘어 계산 효율(산술 강도)이 올라갑니다. 4편에서 소개한 루프라인 그래프에서 오른쪽으로 이동하는 효과입니다. 정리하면 이렇습니다.
혼자 쓰는 로컬 환경: MoE는 "메모리는 많이 쓰지만 빠른" 모델입니다.
여러 명이 쓰는 서버 환경: MoE는 "같은 품질 대비 계산량이 적은" 모델입니다.
그리고 활성 파라미터가 같다고 품질까지 같은 건 아닙니다. 35B-A3B 모델이 3B 일반 모델보다 훨씬 똑똑한 이유가 "출근해 있는 전문의 전체의 지식"을 쓰기 때문입니다. 반대로 32B 일반 모델과 품질이 같다는 보장도 없으니, 용도에 맞게 직접 비교해 보셔야 합니다.
4. 그래서 내 장비로는 어떤 MoE를 돌릴 수 있나
2편의 그래픽카드 추천과 이어지는 내용입니다.
VRAM 16GB (RTX 5060 Ti 16GB 등)
gpt-oss-20b: OpenAI가 16GB 메모리 장비에서 돌아가도록 만든 모델이라 GPU에 전부 올라갑니다. 활성 3.6B라 속도도 빠릅니다.
Qwen3.6-35B-A3B: Q4로 약 21GB라 16GB에는 다 안 들어갑니다. 하지만 llama.cpp의 MoE 전문가 CPU 오프로드 옵션(--n-cpu-moe 등)으로 전문가 일부를 일반 RAM에 두면, 활성 파라미터가 3B밖에 안 돼서 일반 모델을 CPU로 넘길 때보다 훨씬 쓸 만한 속도가 나옵니다.
VRAM 24GB (중고 RTX 3090 등)
Qwen3.6-35B-A3B: Q4 약 21GB로 GPU에 전부 올라갑니다. 토큰당 읽는 양이 약 1.8GB라, 3090 기준 이론 상한이 일반 32B 모델(약 48tok/s)의 10배 가까이 됩니다. 실제로는 그보다 훨씬 덜 나오지만 체감 차이가 큽니다.
통합 메모리 128GB (AMD Ryzen AI Max+ 395 미니 PC, 대용량 Mac 등)
gpt-oss-120b: 117B 모델이지만 단일 80GB GPU에 올라가도록 만들어진 모델이라 128GB 통합 메모리 장비에 들어갑니다. 대역폭이 약 256GB/s로 낮지만 활성이 5.1B뿐이라, 이론 상한이 약 95tok/s 수준입니다. "대역폭은 낮고 용량은 큰" 장비와 MoE의 궁합을 보여주는 대표적인 예입니다.
데이터센터급
K-EXAONE, Qwen 3.5(397B), DeepSeek V4: 전체 파라미터가 수백 B~1조 개 이상이라 여러 장의 데이터센터 GPU가 필요합니다. 이때는 전문가를 GPU별로 나눠 두는 방식(전문가 병렬화)을 쓰고, GPU 사이의 통신 속도가 새로운 병목이 됩니다. 1편에서 K-EXAONE을 H200 4장으로 서빙하는 계산을 다뤘습니다.
5. 체크리스트
모델 카드에서 total params와 active params를 둘 다 확인하세요. 한쪽만 보고 판단하면 안 됩니다.
메모리 견적은 "전체 파라미터 × 0.6GB(Q4) + 대화 기억(KV 캐시)"으로 잡습니다.
속도 견적은 "대역폭 ÷ (활성 파라미터 × 0.6GB)"로 잡되, 여러 명이 동시에 쓴다면 보수적으로 잡습니다.
VRAM이 모자라면 일반 모델보다 MoE를 먼저 고려하세요. 전문가를 CPU로 넘겨도 손해가 상대적으로 작습니다.
양자화할 때 라우터와 공유 전문가는 정밀도를 높게 유지하는 레시피가 많습니다. 품질에 미치는 영향이 다른 부분보다 크기 때문입니다.
6. 시리즈를 마치며
1편부터 5편까지 결국 같은 이야기를 했습니다. LLM의 속도와 비용은 "얼마나 많이 계산하느냐"보다 "메모리에서 얼마나 많이, 얼마나 빨리 읽느냐"가 결정합니다. KV 캐시(1편), 그래픽카드 선택(2편), HBM(4편), MoE(5편) 모두 이 원리로 설명됩니다.
References
LG AI Research, K-EXAONE-236B-A23B 모델 카드, Hugging Face. https://huggingface.co/LGAI-EXAONE/K-EXAONE-236B-A23B
OpenAI, gpt-oss-120b / gpt-oss-20b (2025.08). https://openai.com/index/introducing-gpt-oss/
Shazeer et al., Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer, arXiv:1701.06538 (2017). https://arxiv.org/abs/1701.06538
Fedus, Zoph, Shazeer, Switch Transformers, arXiv:2101.03961 (2021). https://arxiv.org/abs/2101.03961
Jiang et al., Mixtral of Experts, arXiv:2401.04088 (2024). https://arxiv.org/abs/2401.04088
DeepSeek-AI, DeepSeek-V3 Technical Report, arXiv:2412.19437 (2024). https://arxiv.org/abs/2412.19437
llama.cpp (MoE 전문가 CPU 오프로드 옵션). https://github.com/ggml-org/llama.cpp