Cerebras, AI 전용 초고속 웨이퍼 엔진
작성자: 조현우 · 게시판: 자유게시판 · 2026-05-28 00:33 · 추천 3 · 댓글 8
Cerebras 는 초고속 웨이퍼 엔진을 이용하여 Local LLM 을 호스팅 해 주는 회사입니다.
직접 써보니, 빠르긴 확실히 빠릅니다, 웨이퍼 칩 하나의 메모리 대역폭이 H100 보다 7000 배 빠르다고 합니다.
AI 처리속도만 보면 기존 H100 에 비해 10~20 배 빠르다고 하네요.
테스트로 크롬 공룡게임을 리메이크 시켜보았고, 결과는 이렇습니다.
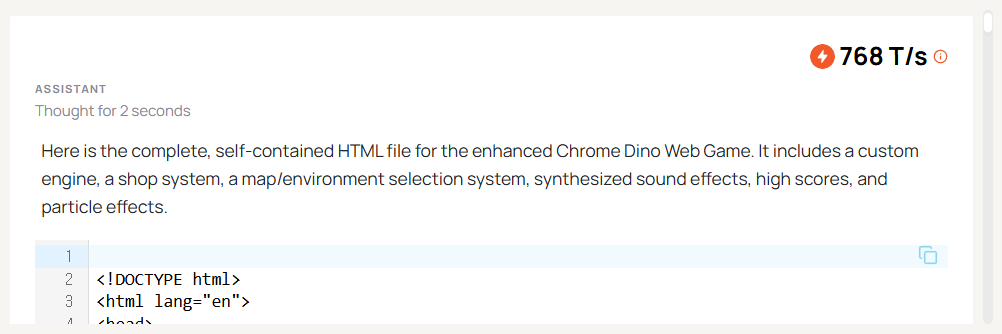
일단 토큰 속도를 보면 768T/s 입니다.
평상시에도 평균적으로 800T/s 는 나오는 것 같고, 운 좋으면 1000T/s 이상 나오는 경우도 있습니다.
1000줄 쓰는데 대략 5초 밖에 안 걸려서 놀라웠습니다.
게임 퀄리티 같은 경우도 나쁘지 않습니다.
GLM 4.7 모델을 이용하였고, 구현 요청한건 다 잘 구현했습니다.
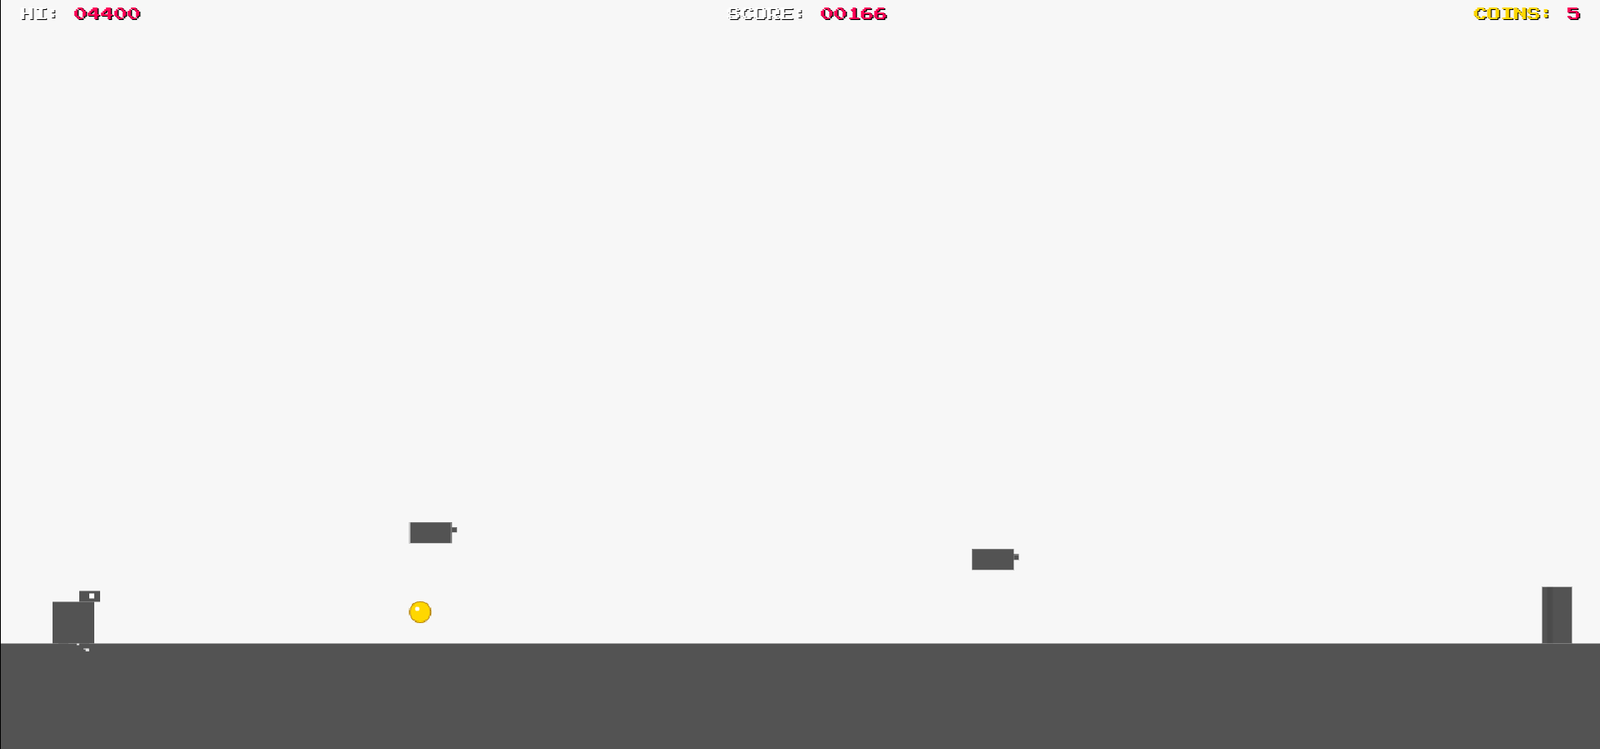
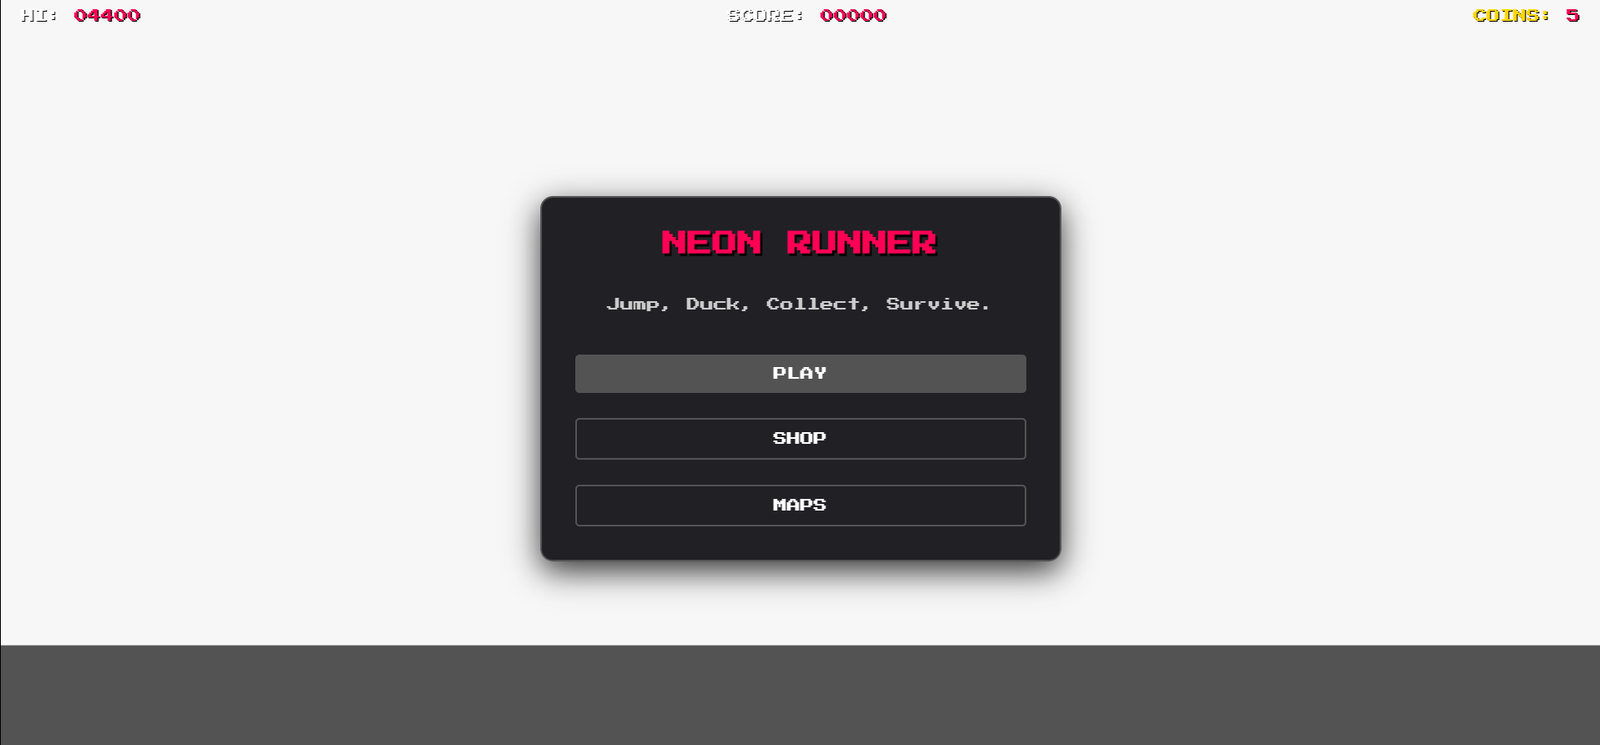
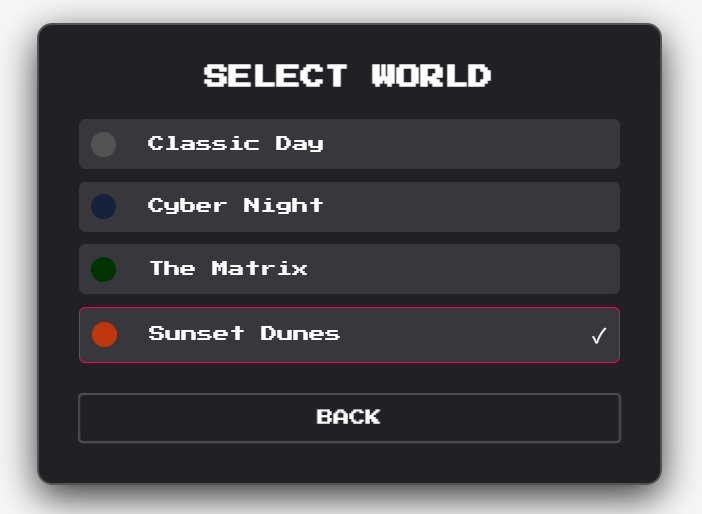
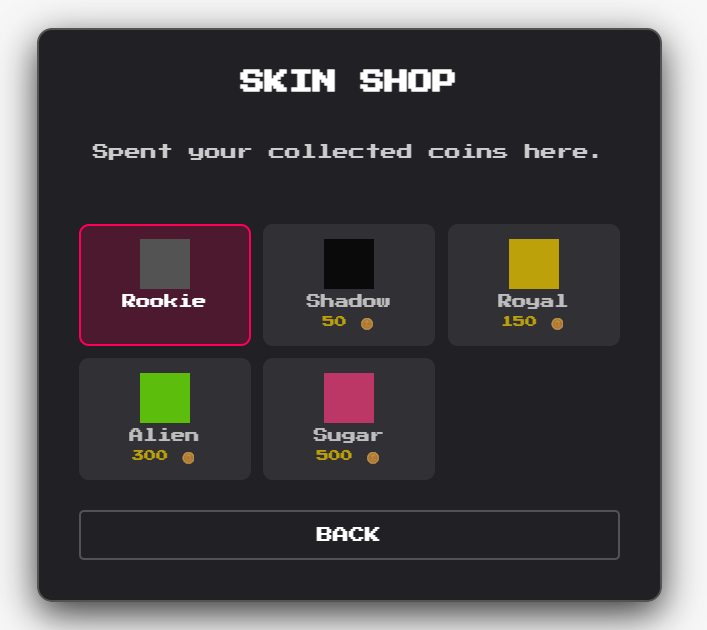
비교 목적으로 시험 삼아 Gemini 3.5 Flash 에게도 개발을 시켜보았습니다.
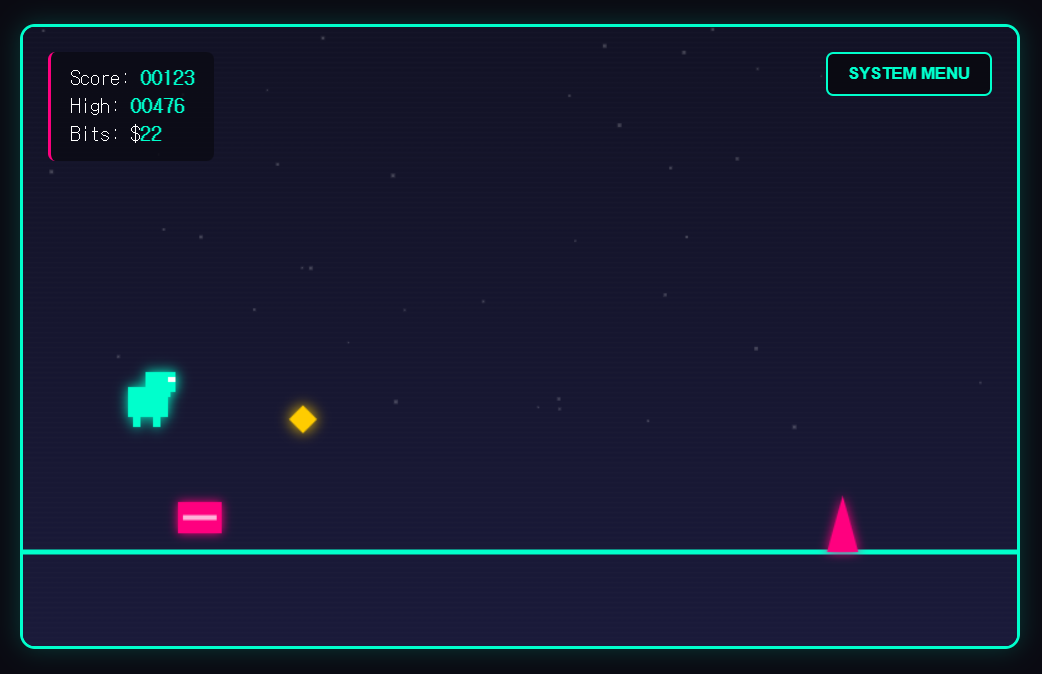
사실 Gemini 가 좀 더 움직임이 부드럽고 게임 같은 느낌이 있었지만, 그래도 크게 뒤쳐지는 정도는 아니었습니다.
게임 퀄리티는 모델 역량이기 때문에 Cerebras 의 핵심인 웨이퍼 칩 성능과는 무관합니다.
하지만, 중요한 것은 저 정도 속도로 모델이 Cerebras 인프라 위에서 아무 문제 없이 잘 돌아가고, 성능 저하도 없다는 점 입니다.
아쉬운 점은, 요즘 DeepSeek V4, GLM 5.1 처럼 좋은 오픈소스 모델들도 나오는데 GLM 4.7, llama 8b 정도의 낮은 급의 모델들만 제공한다는 것입니다.
물론, 계속해서 인프라를 확장시키고 모델도 늘리고 있지만, 아직 많이 부족하다고 느낍니다.
하지만 그만큼 앞으로의 발전 가능성이 크다고 생각합니다.
특히 Perplexity 의 Sonar 모델이 Cerebras 의 인프라를 이용하여 속도를 극대화 하는 등 다양한 협업이 이루어지고 있습니다.
(https://www.cerebras.ai/press-release/cerebras-powers-perplexity-sonar-with-industrys-fastest-ai-inference) -- 사실 좀 옛날에 한 것이긴 합니다.
마지막으로, Cerebras 를 활용하는 몇 가지 활용 방안을 정리 해 보았습니다.
1. API 를 Harness 에다가 연결
2. 초고속 브레인스토밍
3. 대용량 문서 분석
저는 pi Harness 에다가 Cerebras 라우팅해서 사용해 보려고 시도 중 입니다.
잘 된다면 나중에 후기를 공유하도록 하겠습니다.
여러분의 의견은 어떤가요?